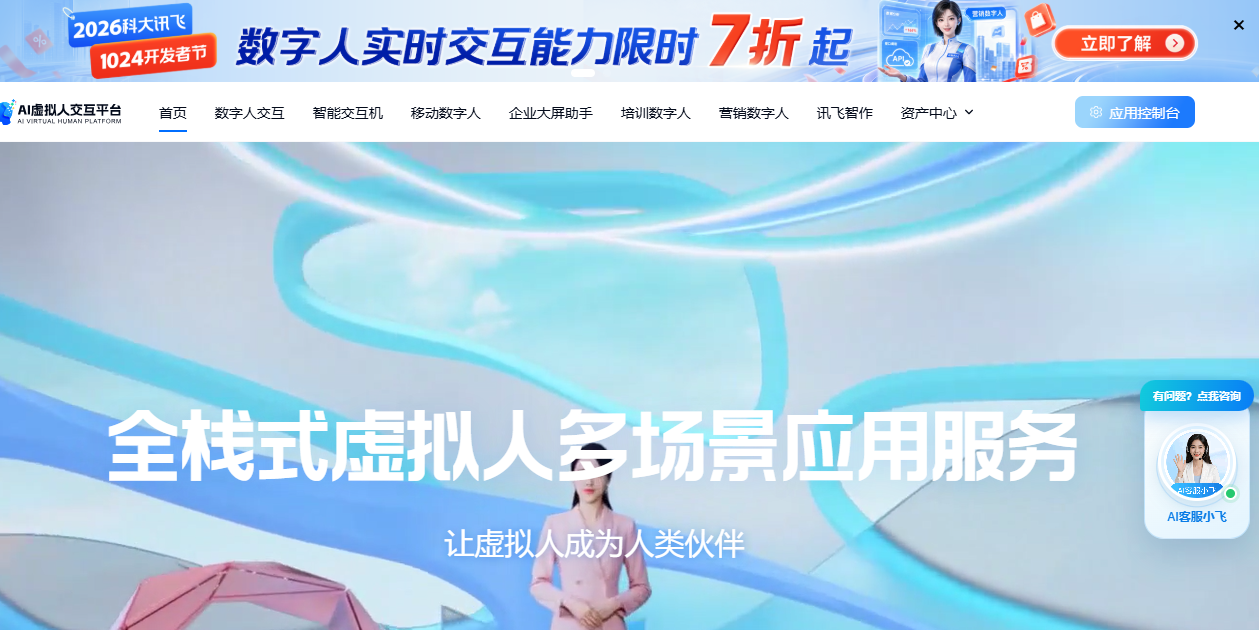
摘要:讯飞虚拟数字人是科大讯飞打造的全栈式AI虚拟人应用服务平台,整合语音合成、星火大模型与形象克隆技术,覆盖内容生产、智能交互与多终端部署,帮助企业与创作者以更低门槛构建专属数字人资产。
一、讯飞虚拟数字人是什么
讯飞虚拟数字人并非单一工具,而是一个产品族矩阵,其核心底座是科大讯飞自研的语音识别、语音合成、语义理解与星火大模型能力。从使用形态上划分,它主要包含三条落地路径:面向内容创作者的讯飞智作(音视频一站式生成)、面向线下交互的智能交互机与移动数字人(大屏终端与可移动导览设备),以及面向开发者的能力开放体系(终端SDK、服务端API、公有云API与私有化部署)。简言之,它解决的是“让数字人从技术演示走向可用生产力”的问题:新闻机构输入文字即可生成播报视频,企业展厅可以部署能带路的数字讲解员,品牌方能拥有持续互动的数字代言人,而不必从建模、配音到驱动集成逐一攒队。
二、表单基本信息
| 项目 | 内容 |
|---|---|
| 工具/平台名称 | 讯飞虚拟数字人(含讯飞智作、智能交互机、移动数字人等产品线) |
| 官网网址 | https://virtual-man.xfyun.cn |
| 上线时间 | 核心交互平台1.0于2021年10月发布;讯飞智作于2023年4月正式发布 |
| 产品功能 | 形象克隆、声音复刻、3D形象定制、文本转数字人视频、智能交互、多终端部署、API能力开放 |
| 价格优惠 | 提供免费体验包(交互时长600分钟/30天);在线虚拟人驱动年费套餐30,000元起;讯飞智作配音会员公开资料口径约45元/月起,含虚拟人的标准档公开口径约319元/月 |
| 所属公司 | 科大讯飞股份有限公司(深交所上市,SZ002230) |
三、主要功能
3.1 形象克隆与3D定制
平台支持两种形象获取路径。真人分身克隆仅需录制约5分钟真人正面视频,系统即可训练生成1∶1数字分身,之后输入文本便能驱动分身生成播报视频。3D形象定制则覆盖超写实、卡通、美型等风格,支持换装、动作调整与DIY捏脸,无需专业建模基础即可完成个性化虚拟形象搭建。形象资产库内置上百款2D/3D形象,覆盖营销推广、教育培训、新闻播报、直播带货等典型场景,用户也可以跳过定制直接选用现成形象快速出片。
3.2 声音复刻与多语种播报
声音能力是讯飞虚拟数字人区别于多数竞品的核心长板。依托星火语音大模型,一句话复刻功能允许用户仅录制一句话或3—5秒自然语音,即可提取声纹特征生成专属音色,无需专业录音设备。复刻后的声音支持多情感、多语种表达,平台侧已覆盖37种语言及37种方言的播报与交互能力,在跨境场景与方言服务场景中具备直接可用性。
3.3 文本/PPT转数字人视频
讯飞智作承担了“轻量内容生产”的职能。用户选定虚拟人形象后,输入文稿或导入PPT/文案,系统自动完成口型同步、表情匹配与音视频渲染,官方标称3分钟内可完成出稿。该功能将传统需要主播档期、录音棚与后期剪辑的流程压缩为单人操作,尤其适合新闻快讯、课程讲解、企业宣讲等高频、标准化的视频产出场景。
3.4 智能交互与多终端部署
平台不止于“做视频”。智能交互机以一体机终端形态实现面对面问答与业务导览;移动数字人搭载激光雷达与感知模组,可自主避障、边走边讲解,适用于展厅、政务大厅与文旅场景;企业大屏助手则通过语音指令驱动数据大屏的内容调度与讲解。在交互深度上,垂直领域知识库的接入降低了回答幻觉率,人设自定义与长期记忆能力使数字人在连续交互中保持稳定的角色设定。
3.5 能力开放与私有化接入
对于有自建系统集成需求的企业与开发者,讯飞提供终端SDK、服务端API、公有云API及私有化部署方案,支持将虚拟人驱动与交互能力嵌入APP、Web、小程序或既有业务系统。这一层开放能力使讯飞虚拟数字人从“成品工具”延伸为可被二次封装的基础设施。
四、发展历程
讯飞在虚拟人方向的布局呈现出清晰的阶梯节奏,而非单点产品的突然出现。2018年,AI虚拟主播“康小辉”亮相央视,验证了虚拟形象在严肃播报场景中的可用性。2021年10月,AI虚拟人交互平台1.0正式发布,提出多模感知、情感贯穿、多维表达、自主定制的框架,将虚拟人从“展示品”推向可交互平台。2023年4月,讯飞智作作为AIGC内容创作平台独立发布,同年8月升级至2.0,接入星火多模态能力,增加了文件转视频、视频AI后期等AIGC功能,明确了“内容生产”这一高频落地切口。2024年,平台获得信通院大模型数字人基础能力最高等级L5认证,在标准层面确立了技术位次。2026年7月,讯飞首次发布“超拟人数字人实时生成技术”,将数字人构建从依赖长周期视频采集训练,推进到“一张照片即可实时生成数字人并开展自然交互”的阶段,同期升级了交互服务数字人、营销数字人与培训数字人方案,并上线数字人生态共建计划。
五、核心优势
语音与口型的原生一致性。讯飞以语音技术起家,虚拟人的口型预测、表情生成与语音合成在同一技术栈内完成,多篇横评均将“口型匹配度高”“语音质感突出”列为讯飞系数字人的首要辨识点。这一底层一致性在长文本播报、多语种切换时体现得尤为明显,减少了“声画两张皮”的后期修补成本。
从内容到交互的全链路覆盖。多数数字人产品止步于视频生成,讯飞则打通了“做视频—做直播/交互—做硬件终端—做API集成”的连续路径。用户可以从讯飞智作的低门槛内容生产起步,随着需求深化自然过渡到智能交互机或移动数字人,无需更换技术底座与资产体系。
实时生成带来的成本结构改变。传统数字人定制往往需要数小时真人视频采集与较长训练周期,2026年发布的超拟人实时生成技术将入口压缩至单张照片,对于需要快速批量上线数字人分身的企业而言,边际成本显著下降。配合免费体验包与分层订阅定价,个人创作者与中小团队也能以较低试错成本进入。
垂直场景的知识沉淀。星火大模型叠加行业知识库的架构,使交互型数字人在政务、金融、文旅等对回答准确性要求较高的场景中具备可用性基础,而非停留在开放闲聊层面。
六、如何使用
6.1 使用路径选择
讯飞虚拟数字人的使用起点取决于目标场景。若目标是产出音视频内容,直接进入讯飞智作,从形象库选用现成虚拟人或上传素材定制分身,输入文本或PPT即可生成视频。若目标是线下交互部署,则需要根据点位特征选择智能交互机(固定点位)或移动数字人(需自主移动的展厅/导览场景),并配置知识库与交互界面。若目标是系统集成,从能力开放入口获取SDK/API文档,在测试环境中完成驱动与交互能力的对接。
6.2 通用操作流程
以内容生产为例,典型步骤为:第一步,登录平台并从资产中心选择形象与声音——可以选用预置资产,也可以走“5分钟视频克隆形象 + 一句话/5分钟音频复刻声音”的定制路线。第二步,输入播报文本,按需调整多音字、停顿与情感参数,或直接导入PPT让系统提取讲稿。第三步,预览口型与表情匹配效果,确认后渲染导出。官方标称标准视频渲染在3分钟量级完成。第四步,根据分发场景选择直接下载,或通过推流、API将内容推送至直播、大屏或业务系统。
七、使用教程
7.1 真人形象克隆教程
进入讯飞虚拟人平台的“形象克隆”或“资产定制”入口,按平台规范录制一段约5分钟的正面出镜视频。录制环境要求光线均匀、面部无遮挡、背景简洁,以避免训练素材引入噪声。上传后由平台进行AI训练,训练完成后专属分身即进入个人资产库,后续输入文本即可驱动该分身生成视频,替代真人反复出镜。对于追求更快上手的场景,也可以跳过克隆,直接在形象库中选取适配行业气质的预置形象开始创作。
7.2 声音复刻教程
在声音资产模块选择“声音复刻”,录制一句话或3—5秒自然语音。系统提取声纹特征后生成专属音色,用户可在文本转语音或数字人视频中选择该音色作为发声源。若需要多语种或方言输出,在合成前选择目标语言/方言标签,平台会基于同一音色进行跨语种适配,而非要求用户用每种语言重新录制。
7.3 文本转数字人视频教程
选定形象与音色后,将文稿粘贴至编辑区。对于长文本,建议按语义段落分段生成后再拼接,以降低单次渲染的等待感知并便于局部修改。口型同步由系统自动完成,用户可重点检查专有名词的读音准确性与数字的播报格式。预览确认后导出。若用于直播推流,则通过平台提供的推流地址接入直播工具,数字人即可承担不间断的口播任务。
7.4 智能交互机/移动数字人部署教程
硬件形态的部署需要经过场景知识库配置——将业务问答、导览词条、产品信息导入知识库,设定数字人的回答边界与人设语气;界面与唤醒方式配置——根据终端形态设置语音唤醒、触屏唤醒或人脸唤醒;点位部署与联调——固定交互机落地后测试拾音与噪声环境下的识别率,移动数字人则需完成地图建图、避障测试与行走路线设定。对于复杂噪声环境,讯飞提供的多麦阵列与多模态一体机可在硬件层提升拾音质量。
八、最新动态
2026年7月30日,科大讯飞在北京举行智能交互数字人平台升级发布会,核心发布包括:超拟人数字人实时生成技术首次对外亮相,数字人构建从“实时驱动”进入“实时生成”,单张照片即可生成可实时交互的数字人分身,并支持取物、喝水、唱歌、跳舞等复杂动作;交互服务数字人、营销数字人、培训数字人三条产品线同步升级,分别面向品牌直播/客服、数字代言人与内容矩阵、企业培训场景;数字人生态共建计划上线,邀请行业伙伴共同拓展场景。同期,移动数字人系统以星火大模型V4.0为核心引擎完成升级,强调“智能交互、自由移动、全场景适配”的跨越。在标准与合规侧,平台于2026年首批通过中国电子标准院“数字人通用技术”全量功能符合性评测,此前已于2024年获得信通院L5等级认证。
九、竞品对比
数字人赛道的产品定位分化明显,直接比较“谁更好”意义有限,更有效的方式是看场景匹配度。下表选取四个常被同时提及的平台,从定位、语音与语言能力、内容生产链路、价格量级与典型场景进行横向对照。
| 对比维度 | 讯飞虚拟数字人(讯飞智作) | 腾讯智影 | 百度智能云曦灵 | HeyGen |
|---|---|---|---|---|
| 核心定位 | 语音驱动的全栈数字人,内容生产+交互终端+能力开放 | 微信生态内数字人创作与剪辑一体化 | 文心大模型支撑的政企数字人交付 | 跨境出海导向的数字人视频生成 |
| 语音与口型 | 语音合成原生优势,口型匹配度高,多语种多方言覆盖广 | 以中英为主,口型表现稳定 | 公开资料称30种以上语言 | 公开资料称175种语言,侧重跨境场景 |
| 内容生产 | 文本/PPT转视频,3分钟级出稿;同时覆盖直播推流与硬件交互 | 制作与剪辑在同一平台完成,发布链路短 | 面向政企项目的定制交付 | 视频生成链路成熟,模板化程度高 |
| 价格量级(公开资料口径) | 免费体验包 + 标准档约319元/月 + 企业级年费/定制 | 199元/月起,有免费额度 | 5500元+/年起 | 海外定价,按月订阅 |
| 典型适配场景 | 课程培训、新闻播报、企业宣讲、政企交互、多方言服务 | 视频号/公众号运营、短视频创作者 | 政务、金融、教育机构项目制交付 | 跨境自媒体、外贸企业多语种内容 |
讯飞虚拟数字人的差异化落点在于:当需求同时涉及中文(及方言)语音质量、内容生产效率和线下交互终端时,它在同一体系内提供的完整度高于以视频生成为主的工具;其硬件终端形态(交互机、移动数字人)也是多数纯软件竞品不具备的交付能力。反之,若核心需求是极致的海外多语种覆盖或微信生态内的快速发布,腾讯智影与HeyGen的匹配度可能更高。
十、FAQ帮助
问:讯飞虚拟数字人和讯飞智作是同一个东西吗?
答:讯飞智作是讯飞虚拟数字人体系中的内容生产产品线,聚焦文本/PPT转数字人视频与配音;讯飞虚拟数字人还包含智能交互机、移动数字人、能力开放等更广的产品矩阵。
问:没有视频制作经验,能用讯飞虚拟数字人做出可用的视频吗?
答:可以。选用预置形象与音色后,输入文本即可生成带口型同步和表情的数字人视频,官方标称渲染在3分钟量级完成。形象克隆与声音复刻也只需数分钟素材,不需要建模或剪辑基础。
问:声音复刻需要录制很长时间吗?
答:不需要。一句话复刻功能支持3—5秒语音生成专属音色;若追求更高还原度,也可按平台指引录制约5分钟音频进行训练。
问:支持哪些语言和方言?
答:平台交互与播报能力覆盖37种语言,声音复刻与合成侧支持37种方言及多语种适配,具体语种列表以官方购买/配置页面为准。
问:可以免费试用吗?
答:提供免费体验包,例如在线虚拟人驱动免费包含600分钟交互时长、30天有效期,适合在正式采购前验证形象、声音与交互效果。
问:讯飞虚拟数字人能部署在本地服务器吗?
答:支持。能力开放体系提供私有化部署方案,适用于对数据驻留或网络环境有特定要求的企业与机构。
问:数字人可以在直播中实时互动,还是只能播放预生成视频?
答:两者均可。讯飞智作生成预渲染视频用于内容发布;智能交互数字人与移动数字人方案支持实时问答、语音指令响应与主动交互,可用于直播、客服与导览场景。
问:价格页面上的数字和第三方测评不一致,以哪个为准?
答:数字人平台的价格口径在第三方渠道容易出现版本混杂。下单前应以官网购买页或商务报价为唯一依据;本文引用的公开资料口径仅用于判断量级,不代表当前实时定价。
问:做好的数字人资产可以迁移或复用到不同终端吗?
答:形象资产与声音资产在平台体系内共用,同一分身可用于讯飞智作视频生成、智能交互机交互以及API集成场景,不需要在不同终端间重复克隆。
暂无评论内容