


做 AI Agent 部署这些年,我见过太多”十分钟跑起来、三天踩不完坑”的项目。绝大多数个人 Agent 的默认形态是单用户、单会话、单前端——你写一个 prompt,接一个模型,挂一个网页,就此结束。但一旦你想让它同时服务两个人,麻烦就来了:会话串台、记忆互相覆盖、IM 机器人和网页端两套状态、后台定时任务跟交互请求抢资源。解决这类问题,行业里常见的路子是”拆服务”,Web 一个进程、Bot 一个进程、Worker 一个进程,再加一个消息队列和一套共享存储,运维复杂度立刻翻几倍。
腾讯云开源的 Octop 走的是另一条路:它把 Web 控制台、CLI、IM 接入、定时任务全部装进同一个进程,用 octop run 一条命令同时拉起。多用户靠 JWT 做租户隔离,多智能体靠 AgentTeams 做协同,人格系统内置了 MBTI 模板。MIT 协议,数据全部落在 ~/.octop/ 一个目录里。这个设计对于个人和小团队而言,几乎是把”自托管 AI Agent”的部署门槛压到了最低。
但低门槛不等于没有坑。这篇教程我会从架构讲起,讲清楚一条命令为什么能同时起四种服务、这套单进程模型的天花板在哪里、多用户隔离的真实安全边界到底划在哪条线上,然后给出可以直接照抄的安装、启动、首次登录、IM 渠道接入、定时任务、备份恢复和排错流程。文中所有配置模板都是模板,字段名以你实际拉到的版本为准,我会在易变的地方明确标注。
架构解读:一条 octop run 同起四种服务是怎么做到的
Octop 是什么:一句话定位与几个关键事实
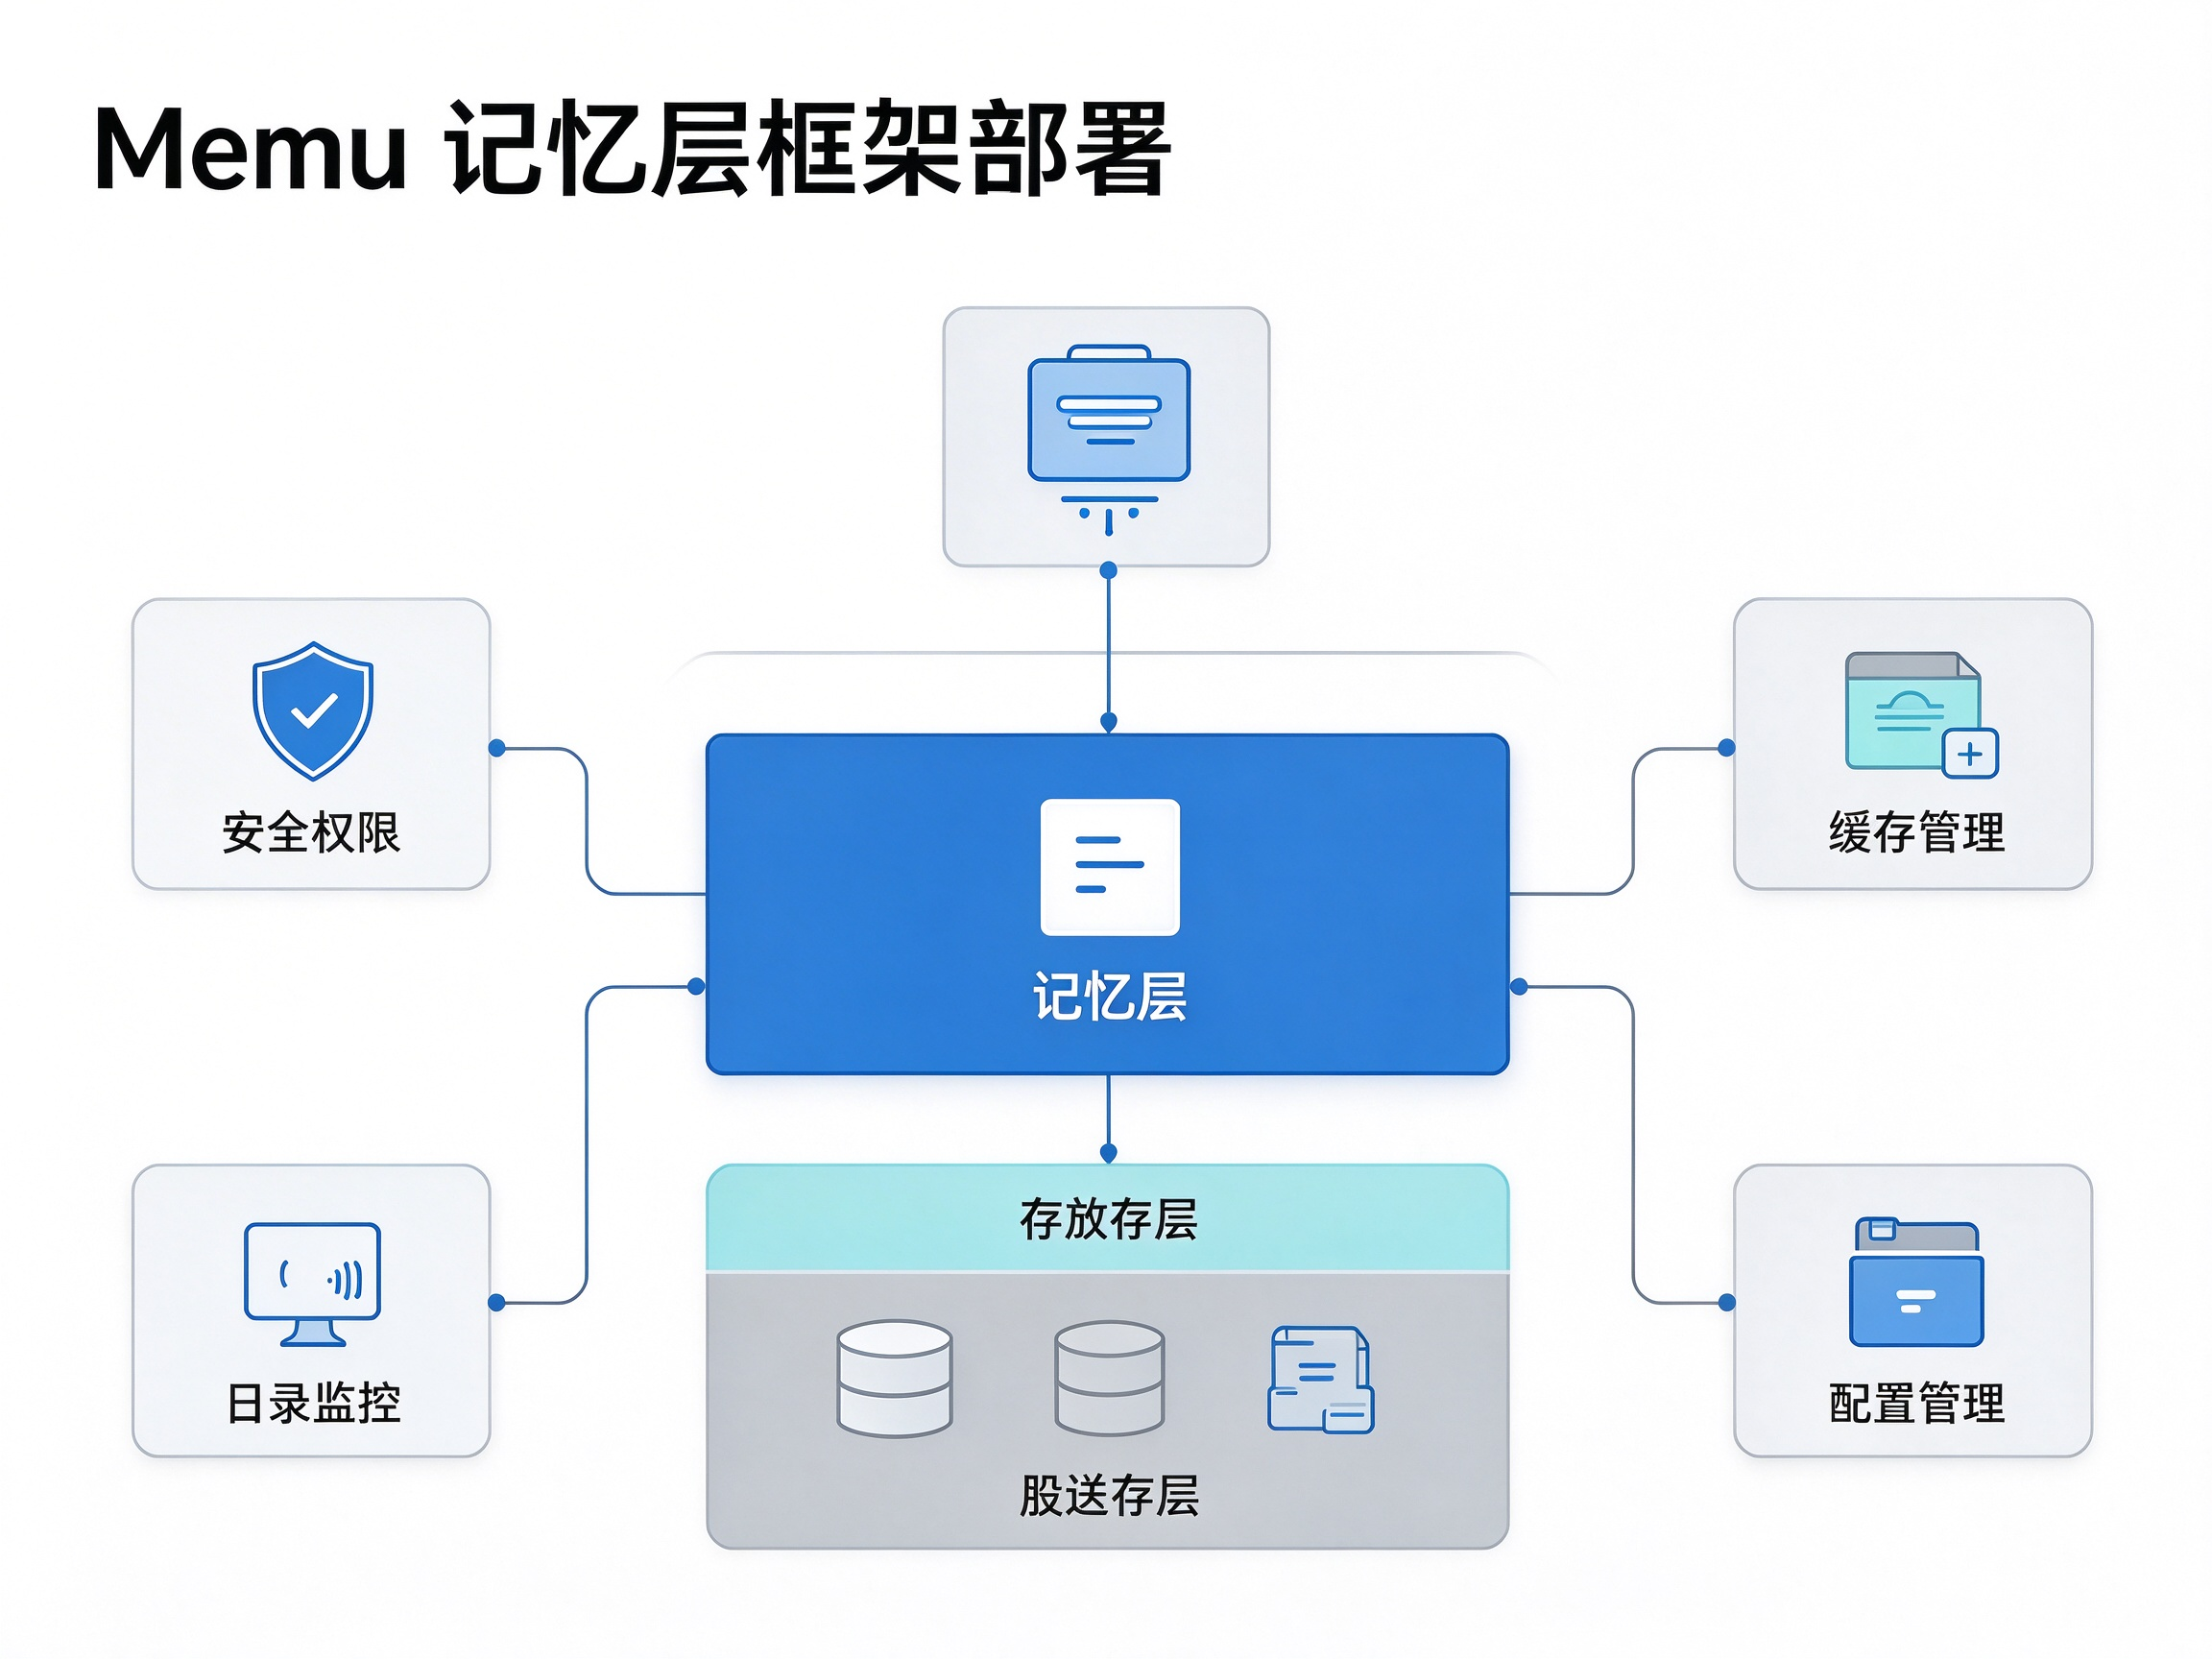
Octop 是腾讯云开源的多用户、多智能体个人 AI Agent 平台,MIT 协议。它的定位不是”企业级 Agent 中台”,而是”一个人或者一个小团队能自己跑起来、自己管理的 Agent 平台”。所有核心能力都是内置的:
- 单进程架构:
octop run一条命令同时启动 Web 控制台、CLI、IM 接入与定时任务四类服务。 - IM 渠道齐全:飞书、钉钉、QQ、微信、Telegram、Discord、企业微信,七类渠道。
- 多用户隔离:基于 JWT 的多租户机制,桌面端、CLI、IM 共用同一套身份体系。
- 多智能体协同:内置 MBTI 人格模板,支持 AgentTeams 组织多个 Agent 分工协作。
- 数据本地化:全部状态落在
~/.octop/,备份就是打包一个目录。
这几条合在一起,构成一个很清晰的取舍:用单进程换运维简单,用本地目录换数据主权,用进程内并发换多服务解耦。理解了这组取舍,后面所有的”为什么这么配”和”为什么这里会卡住”都能自己推导出来。
这篇适合三类人:第一类是个人用户,想给自己配一个 7×24 在线的私人助理,每天从飞书或微信里直接对话;第二类是小团队技术负责人,想用一台 4C8G 的云服务器给 5 到 10 个人搭一套共享的 Agent 平台;第三类是已经用过单用户 Agent、被多会话串台折腾过的人,想知道 Octop 的多用户到底是怎么实现的、可靠不可靠。
读完之后你应该能做到:在一台干净的 Linux 机器上从零完成 Octop 部署,成功登录 Web 控制台,接入至少一个 IM 渠道,给两个用户开账号并验证数据隔离,建一个两人 AgentTeam 跑通一次协作,并且知道备份和恢复的正确姿势。
先把最核心的问题讲透。很多人第一次看文档,看到”一条命令启动 Web、CLI、IM、定时任务”,第一反应是”它是不是在背后偷偷拉起了四个子进程”。不是。Octop 的四类服务共享同一个进程、同一个事件循环、同一个数据目录、同一套身份与模型配置。这正是它能一条命令起来的原因,也是它的能力上限所在。
四类服务共用一个进程意味着什么
在一个传统拆服务架构里,Web 服务和 IM 适配器要通信,得走 HTTP 或者消息队列:Web 端发的消息要序列化,过网络,被 IM 服务反序列化,再交给 Agent 运行时。中间每一次序列化都有成本,每一次网络调用都有失败模式,而且两份服务各自要读一遍用户表和 Agent 配置——配置漂移就是这么来的。
Octop 把它们压进一个进程之后:
- 身份只有一份:Web 的 cookie、CLI 的 token、IM 渠道绑定的用户,最终都归一到同一套用户记录,没有”Web 端是 A、机器人以为是 B”的问题。
- 会话只有一份:你在网页里跟某个 Agent 聊到一半,切到飞书继续聊,识别出来还是同一个用户和同一个 Agent 上下文。
- Agent 运行时就只有一份:模型配置、人格模板、工具权限不用为每个入口重复加载。
- 调度器天然能看见所有请求:定时任务和交互请求在同一进程里,排队与限流可以在进程内直接做。
代价也很明确:任何一类服务的阻塞都会影响全部。比如某个 IM 渠道的 webhook 回调处理写得不好,长时间同步阻塞,Web 页面也会跟着变卡。所以部署阶段最重要的一件事,是确认你的硬件和超时配置能扛住四类服务并发,而不是去追问”能不能只启动 Web 不启动 IM”。
四类服务各自承担什么职责
| 服务类型 | 入口形态 | 核心职责 | 是否必需 | 典型使用场景 |
|---|---|---|---|---|
| Web 控制台 | 浏览器 HTTP/WebSocket | 用户管理、Agent 配置、会话交互、渠道配置、查看日志 | 是,首次部署与配置全靠它 | 建账号、配模型、调人格、看运行状态 |
| CLI | 终端命令行 | 本地交互、脚本化调用、批量任务、运维检查 | 是,octop run 本身就是 CLI |
服务器上直接对话、写 crontab 调用、调试渠道 |
| IM 接入 | 各平台机器人回调 | 把飞书/钉钉/微信等消息转成统一事件,回送到 Agent | 否,但这是日常主力入口 | 手机里直接找 Agent 干活 |
| 定时任务 | 进程内调度器 | 按 cron 表达式触发 Agent 任务、渠道推送 | 否,但决定自动化价值 | 每日简报、定时巡检、周报汇总 |
单进程架构的天花板在哪里
这是我个人认为最该提前讲清楚的一点,因为它决定了你该给 Octop 配多大的机器、能用多久、什么时候该换方案。
天花板之一:CPU 核数与事件循环
单进程意味着它在最理想的情况下也只能吃满一个 CPU 核心的同步计算。模型调用是 IO 密集型,绝大多数时间在等 API 返回,所以并发几十个会话并不会把 CPU 打满。但一旦某个环节做了重计算(比如长文本拼接、大量文件解析、PDF 抽取),它就会和所有其他请求争抢同一个事件循环。经验判断是:5 到 10 个活跃用户、日常以对话和轻量工具调用为主的场景,2C4G 够用;超过 20 个活跃用户或者要做批量重任务,直接上 4C8G 并考虑把重任务拆到外部。
天花板之二:内存与长会话上下文
每个活跃会话都会持有上下文。多用户的差别在于,以前你只需要为一个会话留内存,现在要给 N 个用户各留一份。内存不足的典型表现不是直接崩溃,而是 OOM Killer 悄悄杀掉进程然后被 systemd 拉起来——你只看到”它偶尔重启一次”。所以部署时一定要配 systemd 的 MemoryMax 或者用容器限制内存,让问题显性化,而不是让它静默发生。
天花板之三:横向扩展不是加机器就完事
这是单进程架构最容易被误解的地方。很多人以为”单进程 = 起不了多实例 = 不能扩容”。其实起多实例是可以的,但前提是你得把状态从进程内存里挪出去:~/.octop/ 下的数据库要换成共享存储,会话状态要能跨实例访问,定时任务要做分布式锁防止重复触发,IM 渠道的回调要做路由。这一套做下来,成本就回到了”拆服务”那条路。所以我的判断是:Octop 的设计目标是”一台机器、一个团队”,如果团队规模注定要突破这个量级,趁早规划数据层外置,而不是先把用户堆上去再说。
一张图看清请求链路
从 IM 收到一条消息到 Agent 回复,中间大致经过这几步,理解它对你排查问题极有帮助:
- IM 平台把用户消息推给 Octop 的对应渠道适配器(webhook 或长连接)。
- 适配器根据渠道内的账号绑定关系,找到对应的 Octop 用户身份,签发或复用 JWT 上下文。
- 消息被归一化成统一事件,交给 Agent 运行时,选择对应的 Agent 与人设。
- Agent 运行时调用模型,执行工具,可能调度子 Agent(AgentTeams 场景)。
- 结果按渠道适配器的格式回写,同时落库到
~/.octop/。
线上出问题,90% 卡在第 1 步(回调地址、签名、权限)和第 2 步(绑定关系、JWT 过期)。这两步恰恰是纯配置问题,不涉及模型,所以排错时别一头扎进模型日志里。
安装前置条件与环境准备
Octop 的安装比很多同类项目简单,因为它不依赖一堆外部中间件。但有几个前置条件必须满足,否则后面会以非常隐晦的方式失败。
硬件、系统与网络要求
| 项目 | 最低 | 推荐 | 说明 |
|---|---|---|---|
| CPU | 2 核 | 4 核 | 单进程同步计算只吃一核,多核主要留给工具子进程 |
| 内存 | 2 GB | 8 GB | 多用户长会话是内存大头,2G 仅够 2-3 人轻量用 |
| 磁盘 | 20 GB | 50 GB | ~/.octop/ 会随会话增长,留足余量 |
| 系统 | Linux x86_64 | Ubuntu 22.04 / Debian 12 | macOS 也可本地跑,生产建议 Linux |
| 网络 | 可访问模型 API | 可访问模型 API + 公网入口 | 接 IM 必须有公网可达地址或长连接能力 |
系统基础依赖
先更新系统并装好常用工具。不同的 IM 渠道接入方式可能会用到 curl 来手动测试回调,jq 来解析 JSON,sqlite3 来直接查 ~/.octop/ 下的数据。
sudo apt update && sudo apt upgrade -y
sudo apt install -y curl git jq sqlite3 tmux ufw

# 确认版本(Octop 通常要求较新的运行时版本,低于要求会启动报错)
node -v || echo "未安装 Node.js"
python3 --version
uname -m   # 确认是 x86_64 还是 aarch64,下载包时要用对
创建专用运行用户
这一步很多人跳过,但它是后面 ~/.octop/ 权限问题的根源。不要让 Octop 以 root 跑,也不要用你日常管理的账号跑。单独建一个用户,把数据目录归它所有。
# 创建无登录 shell 的专用用户
sudo useradd -m -s /bin/bash octop
sudo passwd octop

# 切到该用户执行后续所有安装与配置
sudo su - octop
whoami    # 输出应为 octop
echo $HOME  # 输出应为 /home/octop,Octop 的数据目录就在 /home/octop/.octop
为什么要专门强调 $HOME:Octop 的数据目录是 ~/.octop/,这里的 ~ 取决于启动进程的用户。如果你用 root 装完,又用 octop 用户启动,你会看到”配置全丢了”——其实是两套不同的 ~/.octop/。这是新手最高频的”玄学问题”之一,我会在排错一节再提一次。
安装 Octop 与 octop run 启动
前置条件齐了,进入正式安装。下面给出源码方式与预编译包方式两条路径,任选其一。命令中的仓库地址与安装脚本参数请以你拿到的官方发布说明为准,项目迭代较快,参数可能会有微调,必要时先执行 octop --help 查看当前版本支持的全部子命令。
方式一:从源码安装
# 以 octop 用户执行
cd ~
git clone https://github.com/TencentCloud/octop.git
cd octop

# 查看当前分支与版本,确认和文档对应
git branch -a
git describe --tags 2>/dev/null || git log -1 --oneline

# 安装依赖(按项目实际包管理器选择,npm 或 pnpm)
npm install --production
# 或: pnpm install --prod

# 构建(如果有构建步骤)
npm run build 2>/dev/null || echo "无构建步骤,跳过"

# 全局链接,让 octop 命令在任意目录可用
sudo npm link
which octop
octop --version
方式二:使用发布包或安装脚本
# 安装脚本方式(示例,参数以官方为准)
curl -fsSL https://octop.example.com/install.sh | bash

# 手动解包方式
mkdir -p ~/opt && cd ~/opt
# 下载与架构匹配的包:x86_64 用 amd64,ARM 用 arm64
curl -LO https://octop.example.com/releases/latest/octop-linux-amd64.tar.gz
tar -xzf octop-linux-amd64.tar.gz
sudo mv octop /usr/local/bin/
sudo chmod +x /usr/local/bin/octop
octop --version
首次运行:octop run 到底做了什么
octop run 是 Octop 的主入口。它做的事情按顺序大致是:
- 确定数据目录,默认为
$HOME/.octop/,不存在则初始化目录结构与默认配置。 - 加载配置文件,读取模型密钥、端口、JWT 密钥等,缺失项走默认或进入引导流程。
- 初始化数据库,创建用户表、会话表、Agent 配置表、渠道绑定表。
- 启动定时任务调度器,加载已注册的定时任务。
- 启动 IM 渠道适配器,为已配置的渠道建立 webhook 监听或长连接。
- 启动 Web 控制台 HTTP 服务与 WebSocket,监听配置端口(默认常见为 8080 一类,以实际输出为准)。
- 前台阻塞,输出日志;Ctrl+C 退出,同时停止所有服务。
注意第 7 条:所有服务共享一个前台进程,Ctrl+C 一次全停。这也意味着如果你把它直接放在 SSH 会话里跑,断线就全没了。生产必须用 systemd 或 tmux 托管。
# 首次启动(前台,便于观察初始化日志与首登信息)
cd ~
octop run

# 首次启动日志里通常会出现类似内容,务必记下:
#   Web 控制台地址: http://0.0.0.0:8080
#   数据库文件:     /home/octop/.octop/xxx.db
#   管理员引导信息: 首次访问的初始化入口或初始账号
用 systemd 托管 octop run
跑到前台确认没问题之后,立刻转成系统服务。这是 Octop 生产部署必须做的一步。
sudo tee /etc/systemd/system/octop.service >/dev/null <<'EOF'
[Unit]
Description=Octop Multi-User Agent Platform
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=octop
Group=octop
WorkingDirectory=/home/octop
Environment=HOME=/home/octop
Environment=NODE_ENV=production
ExecStart=/usr/local/bin/octop run
Restart=on-failure
RestartSec=5
# 显式限制内存,让 OOM 问题暴露而不是静默杀掉
MemoryMax=6G
# 日志交给 journald
StandardOutput=journal
StandardError=journal
SyslogIdentifier=octop

[Install]
WantedBy=multi-user.target
EOF

sudo systemctl daemon-reload
sudo systemctl enable --now octop
sudo systemctl status octop --no-pager
sudo journalctl -u octop -f这里两个细节值得强调。第一,Environment=HOME=/home/octop 是必须的,否则某些运行方式下 ~ 解析异常,数据会写到奇怪的地方。第二,MemoryMax 一定要设,被 systemd 限制后进程会因为 OOM 直接失败并留下明确日志,你能一眼看到;不设的话它可能被内核 OOM Killer 挑中,表现成”服务偶尔自己重启”。
反向代理与 HTTPS
IM 渠道基本都要求回调地址是 HTTPS。所以在接入渠道之前,先把 Nginx 和证书配好。
sudo tee /etc/nginx/sites-available/octop >/dev/null <<'EOF'
server {
    listen 80;
    server_name agent.example.com;
    return 301 https://$host$request_uri;
}

server {
    listen 443 ssl http2;
    server_name agent.example.com;

    ssl_certificate     /etc/letsencrypt/live/agent.example.com/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/agent.example.com/privkey.pem;

    # WebSocket 必须保留 Upgrade 头,否则网页端会反复断线
    location / {
        proxy_pass http://127.0.0.1:8080;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_read_timeout 600s;
        proxy_buffering off;
    }
}
EOF

sudo ln -s /etc/nginx/sites-available/octop /etc/nginx/sites-enabled/
sudo nginx -t && sudo systemctl reload nginx

# 证书
sudo apt install -y certbot python3-certbot-nginx
sudo certbot --nginx -d agent.example.com
proxy_read_timeout 600s 和 proxy_buffering off 是针对流式输出的。不配的话,你会看到”Agent 明明在思考,网页半天没反应,最后一次性刷出一大段”——不是模型慢,是 Nginx 在攒。
首次登录与基础配置
打开 Web 控制台完成初始化
浏览器访问 https://agent.example.com。首次访问时,Octop 通常会引导你创建管理员账号,或者在日志里给出一个初始化入口。如果服务启动日志里打印了初始账号或引导 token,务必第一时间用它完成初始化,然后立刻修改密码。
# 如果忘了初始信息,从服务日志里捞
sudo journalctl -u octop --since "10 min ago" | grep -iE "admin|token|init|password|port"

# 也可以用 CLI 侧检查状态
octop status 2>/dev/null || echo "当前版本无 status 子命令"
octop --help
配置模型与密钥
登录之后第一件事是配模型。Octop 本身不带模型,它是一个编排层。常见的做法是在 Web 控制台的模型设置里填入你所用模型服务的 API Key 与接入点,也可以在配置文件里预置。密钥建议放在环境变量或专门的 secrets 文件里,不要直接写进会被 git 跟踪的文件。
# 用 systemd EnvironmentFile 管理密钥,避免明文写在 unit 里
sudo tee /etc/octop/octop.env >/dev/null <<'EOF'
MODEL_API_KEY=sk-xxxxxxxxxxxxxxxx
MODEL_BASE_URL=https://api.example.com/v1
MODEL_NAME=your-model-name
JWT_SECRET=请替换为足够长的随机字符串
EOF

sudo chown root:octop /etc/octop/octop.env
sudo chmod 640 /etc/octop/octop.env

# 在 unit 中加入 EnvironmentFile
# 然后 systemctl daemon-reload && systemctl restart octop
JWT_SECRET 这一项是后面多用户隔离的基础,一定要在正式使用之前固定下来,不要中途改。改了之后所有已签发的登录态全部失效,用户会被踢下线;如果你在 IM 渠道里做过用户绑定,也要注意签名变化可能带来的重绑。
推荐的开局配置顺序
- 改管理员密码,开二次验证(如果版本支持)。
- 配模型密钥,在 Web 控制台发一条测试消息,确认能通。
- 确认
~/.octop/下已经生成了数据库与配置文件,记下路径。 - 配置 Nginx + HTTPS,确认
https://能正常访问且 WebSocket 不断线。 - 创建第二个测试用户,验证账号隔离。
- 接入一个 IM 渠道(建议先飞书,接入文档最完整)。
- 配置第一个定时任务,验证调度器工作。
- 写一份备份脚本并加入 crontab。
顺序很重要。很多人在第 2 步没验证通就跳到 IM 渠道,结果渠道里发消息没反应,排查半天才发现是模型密钥填错了——两件事叠在一起,浪费的时间成倍。
~/.octop/ 目录结构、备份与恢复
Octop 最让人省心的地方,就是所有状态都压在一个目录里。~/.octop/ 就是这台机器上 Octop 的”全部身家”:用户、会话、配置、Agent 定义、人格模板、渠道绑定、日志,全在这里。这也是我见过的最适合做”整目录快照”的 Agent 部署形态之一。
典型目录结构
下面的结构是按常见约定整理的示意,不同版本的具体文件名可能有差异。第一次部署完,强烈建议执行一次 tree -L 2 ~/.octop 看一眼真实结构,并写进你自己的运维手册。
# 安装 tree 后查看真实结构
sudo apt install -y tree
tree -L 2 -a ~/.octop
du -sh ~/.octop/*

# 典型输出示意:
# ~/.octop/
# ├── config/              # 应用级配置
# │   ├── app.json         # 端口、日志级别、JWT 相关参数
# │   └── models.json      # 模型接入配置
# ├── data/                # 数据库与业务状态
# │   ├── octop.db         # 主数据库:用户、会话、Agent
# │   └── *.db-wal         # WAL 文件,备份时必须一起带上
# ├── agents/              # Agent 定义与人设
# │   └── <agent-id>/
# ├── personas/            # MBTI 等人格模板
# ├── channels/            # IM 渠道配置
# │   ├── feishu.json
# │   └── dingtalk.json
# ├── tasks/               # 定时任务定义
# ├── uploads/             # 用户上传的文件
# ├── logs/                # 运行日志
# └── secrets/             # 密钥类文件(权限应严格限制)
哪些必须备份,哪些可以不备
| 路径 | 内容 | 是否必须备份 | 恢复后注意事项 |
|---|---|---|---|
data/ |
用户、会话、Agent、渠道绑定 | 必须 | 必须连同 -wal 文件一起,否则可能损坏 |
config/ |
端口、模型、JWT 参数 | 必须 | 换机器时 JWT 密钥保持一致,避免全员掉线 |
agents/ |
Agent 定义与提示词 | 必须 | 纯文件,直接还原即可 |
personas/ |
MBTI 人格模板与自定义 | 必须 | 自定义人格要单独留存版本 |
channels/ |
IM 渠道配置与密钥 | 必须(加密存放) | 含密钥,备份包务必加密 |
tasks/ |
定时任务定义 | 必须 | 恢复后检查触发时间与时区 |
uploads/ |
用户上传文件 | 建议 | 体积大,可单独做归档策略 |
logs/ |
运行日志 | 可不备 | 保留 7 天即可,排错时再找 |
热备份的正确姿势
直接 tar 一个正在被写入的 SQLite 数据库,是很多人踩过的坑。正确做法有两种:用 SQLite 自带的在线备份命令,或者先停服务再打包。
#!/usr/bin/env bash
# /home/octop/backup-octop.sh
set -euo pipefail

SRC="$HOME/.octop"
DEST="/home/octop/backups"
TS=$(date +%Y%m%d-%H%M%S)
WORK=$(mktemp -d)

mkdir -p "$DEST"

# 1. 用 sqlite3 在线备份,保证一致性(先停写或接受极短窗口)
find "$SRC/data" -name '*.db' -print0 | while IFS= read -r -d '' db; do
  name=$(basename "$db")
  sqlite3 "$db" ".backup '$WORK/$name'"
done

# 2. 拷贝纯文件型目录
for d in config agents personas channels tasks; do
  [ -d "$SRC/$d" ] && cp -a "$SRC/$d" "$WORK/"
done

# 3. 打包并加密(因为包含渠道密钥)
tar -czf - -C "$WORK" . | openssl enc -aes-256-cbc -pbkdf2 -salt \
  -pass file:/etc/octop/backup.key -out "$DEST/octop-$TS.tar.gz.enc"

rm -rf "$WORK"

# 4. 保留最近 14 份
ls -1t "$DEST"/octop-*.tar.gz.enc | tail -n +15 | xargs -r rm -f

echo "backup done: $DEST/octop-$TS.tar.gz.enc"
chmod +x /home/octop/backup-octop.sh
# 每天凌晨 3 点备份
(crontab -l 2>/dev/null; echo "0 3 * * * /home/octop/backup-octop.sh >> /home/octop/backups/backup.log 2>&1") | crontab -
# 手动跑一次验证
/home/octop/backup-octop.sh恢复流程与”假恢复”陷阱
恢复最怕的不是恢复失败,而是恢复看起来成功了但实际是空的。常见原因有三个:JWT 密钥不一致导致所有人无法登录;数据库 WAL 文件没带上导致部分数据丢失;文件属主变成了 root 导致服务无写权限。
# 恢复步骤
sudo systemctl stop octop

mv ~/.octop ~/.octop.bak.$(date +%s)
mkdir -p ~/.octop

openssl enc -d -aes-256-cbc -pbkdf2 -pass file:/etc/octop/backup.key \
  -in /home/octop/backups/octop-YYYYMMDD-HHMMSS.tar.gz.enc | tar -xzf - -C ~/.octop

# 关键:修正属主
sudo chown -R octop:octop ~/.octop
sudo chmod 700 ~/.octop/secrets 2>/dev/null || true

sudo systemctl start octop
sudo journalctl -u octop -n 100 --no-pager

# 用 sqlite3 直接确认用户表非空
sqlite3 ~/.octop/data/octop.db ".tables"
sqlite3 ~/.octop/data/octop.db "select count(*) from users;" 2>/dev/null || true恢复之后,一定要做一次真实登录 + 发一条消息 + 看一条历史会话的端到端验证。只看”服务起来了”不算恢复成功。
七类 IM 渠道接入配置模板
这是 Octop 部署里最花时间、也最容易卡住的部分。七个渠道各有各的认证方式、回调要求和权限模型。好消息是,Octop 把它们的差异收口在渠道适配器层,你只需要关心三件事:平台侧的凭证、回调地址、用户绑定关系。
七类渠道接入方式对比
| 渠道 | 接入方式 | 公网要求 | 身份绑定 | 关键凭证 | 部署难度 | 推荐场景 |
|---|---|---|---|---|---|---|
| 飞书 | 事件订阅 + Webhook | 需 HTTPS 回调 | 飞书 user_id / open_id | App ID、App Secret、Verification Token、Encrypt Key | 中 | 国内团队首选,文档完善 |
| 钉钉 | 机器人 + 回调 | 需 HTTPS 回调 | 钉钉 userId | AppKey、AppSecret、机器人 Code、回调 Token | 中 | 企业内部办公,权限体系清晰 |
| 企业微信 | 应用 + 回调 | 需 HTTPS 回调 | 企微 UserID | CorpID、AgentId、Secret、Token、AESKey | 中高 | 已有企微体系的公司 |
| 官方机器人协议 | 部分走长连接 | QQ 号 / 开放 ID | AppID、Token、Secret | 中高 | 社群运营、年轻用户 | |
| 微信 | 公众号/服务号回调 | 需 80/443 且备案域名 | OpenID | AppID、AppSecret、Token、EncodingAESKey | 高 | 面向 C 端的服务号 |
| Telegram | Bot API Webhook 或轮询 | Webhook 需公网;轮询不需要 | Telegram User ID | Bot Token | 低 | 海外访问、个人自用 |
| Discord | Bot + Gateway | 长连接为主 | Discord User ID | Bot Token、Application ID | 低 | 社区、开源团队 |
看清这张表你就能做决策了:如果国内团队、要求合规稳定,选飞书或企微;如果只是个人自用、想两分钟跑通,选 Telegram,因为它只需要一个 Bot Token,而且支持轮询模式,连公网端口都不用开。
通用配置字段与写入位置
无论哪个渠道,落地的配置文件都放在 ~/.octop/channels/ 下,每个渠道一个文件。字段名随版本可能微调,但结构基本稳定:凭证、开关、默认 Agent、用户绑定策略。
{
  "channel": "feishu",
  "enabled": true,
  "app_id": "cli_xxxxxxxxxxxx",
  "app_secret": "xxxxxxxxxxxxxxxxxxxxxxxx",
  "verification_token": "xxxxxxxxxxxxxxxx",
  "encrypt_key": "xxxxxxxxxxxxxxxx",
  "mode": "webhook",
  "webhook_path": "/im/feishu/callback",
  "default_agent": "assistant",
  "bind_policy": "whitelist",
  "allow_users": ["ou_xxxxxxxxxxxxxxxx"],
  "reply_style": "markdown"
}
建议不要手写这个文件。正确做法是先在 Web 控制台的渠道设置里走一遍,让 Octop 生成结构,再对着修改。这样能避免字段名不匹配导致的”配置了但没生效”。
飞书接入:从创建应用到第一条消息
第一步:在飞书开放平台创建企业自建应用
登录飞书开放平台,创建企业自建应用,拿到 App ID 和 App Secret。开启机器人能力,在”权限管理”里至少打开接收消息、发送消息、读取用户基本信息这几项。权限不开全,最常见的现象是”消息能进来但回复发不出去”。
第二步:配置事件订阅
在”事件订阅”里设置请求地址为 https://agent.example.com/im/feishu/callback。飞书会立刻发一个验证请求,Octop 需要正确返回 challenge 才算通过。如果这一步失败,先确认 Nginx 没有拦截、服务外网可达、证书有效。
# 手动验证回调地址是否可达(应返回非 5xx)
curl -i -X POST https://agent.example.com/im/feishu/callback \
  -H "Content-Type: application/json" \
  -d '{"type":"url_verification","challenge":"test-123"}'

# 从服务端看是否收到了这次请求
sudo journalctl -u octop -n 50 --no-pager | grep -i feishu
要订阅的事件至少包括接收消息(如 im.message.receive_v1)。少订阅一个事件,表现就是”用户发了消息,Octop 完全没反应”,日志里也什么都没有——因为你压根没收到。
第三步:绑定用户
飞书渠道里最有价值的设计是用户绑定。把飞书的 open_id 映射到 Octop 的用户账号,之后这个人在飞书里跟 Agent 的对话,用的就是他自己的 JWT 上下文、自己的会话、自己的权限。绑定策略建议先用白名单:
{
  "channel": "feishu",
  "enabled": true,
  "app_id": "cli_xxxxxxxxxxxx",
  "app_secret": "xxxxxxxxxxxxxxxxxxxxxxxx",
  "verification_token": "xxxxxxxxxxxxxxxx",
  "encrypt_key": "xxxxxxxxxxxxxxxx",
  "mode": "webhook",
  "webhook_path": "/im/feishu/callback",
  "default_agent": "assistant",
  "bind_policy": "whitelist",
  "allow_users": ["ou_aaaaaaaaaaaa", "ou_bbbbbbbbbbbb"],
  "user_map": {
    "ou_aaaaaaaaaaaa": "alice",
    "ou_bbbbbbbbbbbb": "bob"
  }
}
白名单 + 显式映射是最稳的开局方式。等跑通了再考虑放开到”首次接触自动建账号”,但那时要配合邀请码或组织成员校验,否则任何能搜到你机器人的人都能白嫖你的模型额度。
钉钉接入要点
钉钉的坑主要在机器人回调的加解密和权限审批。企业应用需要管理员审批权限,这点和飞书不同,要先找管理员走完审批再配回调,否则回调验证会一直失败。
{
  "channel": "dingtalk",
  "enabled": true,
  "app_key": "dingxxxxxxxxxxxx",
  "app_secret": "xxxxxxxxxxxxxxxxxxxxxxxx",
  "robot_code": "dingxxxxxxxxxxxx",
  "callback_token": "xxxxxxxxxxxxxxxx",
  "aes_key": "xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx",
  "mode": "webhook",
  "webhook_path": "/im/dingtalk/callback",
  "default_agent": "assistant",
  "bind_policy": "whitelist",
  "allow_users": ["manager0001"]
}
钉钉这边最容易踩的两个点
第一,回调地址必须和你注册的一字不差,包括最后的斜杠。第二,加解密 key 长度有硬性要求,钉钉的 AES key 是 43 位,少一位或多一位都会在验证阶段失败,而且报错信息往往不明确。我一般建议直接复制平台生成的,不要自己造。
企业微信接入要点
企微是三家里配置项最多的:CorpID、AgentId、Secret、Token、EncodingAESKey 五个缺一不可。企微还有一个特殊要求——可信域名需要在管理后台完成归属校验,通常要上传一个校验文件到网站根目录。
{
  "channel": "wecom",
  "enabled": true,
  "corp_id": "wwxxxxxxxxxxxxxxxx",
  "agent_id": "1000002",
  "secret": "xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx",
  "token": "xxxxxxxxxxx",
  "aes_key": "xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx",
  "mode": "webhook",
  "webhook_path": "/im/wecom/callback",
  "default_agent": "assistant",
  "bind_policy": "org",
  "org_allow_dept": ["1", "2"]
}
注意 bind_policy 我写的是 org,也就是按部门放行。企微的场景通常就是公司内部,按部门放行比按人白名单好维护得多。但前提是 Octop 能正确拿到部门信息,这需要你给应用开”通讯录读取”权限。
其余四类渠道的最小配置
Telegram:最快的验证路径
{
  "channel": "telegram",
  "enabled": true,
  "bot_token": "123456789:AAxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx",
  "mode": "polling",
  "default_agent": "assistant",
  "bind_policy": "whitelist",
  "allow_users": ["123456789"]
}
用 policy: polling 就不需要公网入口,非常适合本地或内网机器先验证整条链路。我一般建议新部署第一阶段用 Telegram 轮询模式跑通,确认没问题再去接飞书或钉钉。
Discord、QQ、微信
# Discord:Gateway 长连接,只需 Bot Token
{ "channel": "discord", "bot_token": "xxxxx", "app_id": "000000000000", "enabled": true }

# QQ:官方机器人,需 AppID/Token/Secret,按官方要求配置回调或长连接
{ "channel": "qq", "app_id": "102000000", "token": "xxxxx", "secret": "xxxxx", "enabled": true }

# 微信:公众号回调,要求 80/443 且域名已备案
{ "channel": "wechat", "app_id": "wx0000000000", "app_secret": "xxxxx",
  "token": "xxxxx", "encoding_aes_key": "43位", "enabled": true }
多渠道共存与冲突处理
Octop 支持同时开多个渠道。这里有一个必须提前想清楚的问题:同一个人既在飞书又在钉钉找你,Octop 会把它们认成同一个用户还是两个?答案取决于你怎么配 user_map。把两个渠道的 open_id 都映射到同一个 Octop 用户名,它们就是一个人的两个入口,会话是共享的;不映射,就是两个独立账号。
两种都可以,但要选一种并保持一致。见过最乱的配置是:飞书进来自动建号、钉钉用白名单映射,结果同一个同事有两个账号,记忆割裂,他还以为”AI 变傻了”。
JWT 多用户隔离:原理、配置与真实安全边界
这一节是本文技术含量最高的部分。很多人用 Octop 的第一反应是”多用户不就是多建几个账号”,其实多用户隔离做得好不好,决定了这套平台能不能给团队用。Octop 选的是 JWT 路线,我先把原理讲清楚,再把它的安全边界划出来。
JWT 在 Octop 里是怎么用的
JWT(JSON Web Token)是一段自包含的凭证,由头部、载荷、签名三部分组成,以点分隔。服务端签发时用密钥签名,校验时用同一密钥验签,验签通过就能信任载荷里的内容,不需要每次查库。
在 Octop 的多用户模型里,大致是这样流转的:
- Web 端登录成功,服务端签发 JWT,载荷里带用户标识与角色,通过 HttpOnly Cookie 或 Authorization 头下发。
- CLI 登录同样拿到 JWT,存在本地凭证文件里,后续请求带上。
- IM 渠道收到消息后,根据渠道绑定关系定位到用户,内部复用该用户的身份上下文。
- 每一次请求到达 Agent 运行时之前,先验签解码,得到
userId,后续所有数据访问都以它为过滤条件。
关键在于第 4 步:隔离靠的是”每个查询都带上 userId 过滤”,而不是”每个用户有独立的数据库”。 这两种方案的可靠性差距非常大,接下来就要讲这一点。
部署时该配哪些参数
# 生成一个足够强的 JWT 密钥(不要用默认值)
openssl rand -base64 48

# 建议的配置项(字段名以实际版本为准)
# JWT_SECRET        签名密钥,一旦启用不要随意更换
# JWT_EXPIRES_IN    有效期,交互场景一般 7d 左右,敏感场景 24h
# JWT_ISSUER        签发者,多实例部署时保持一致
# JWT_REFRESH       是否开启刷新令牌,开启后体验更好
# COOKIE_SECURE     HTTPS 环境下必须为 true
# COOKIE_SAME_SITE Lax 或 Strict几个细节。第一,JWT_SECRET 泄露等于所有用户的身份可被伪造,这是整个隔离体系唯一的根密钥,必须用环境变量注入而不是写在配置文件里。第二,COOKIE_SECURE 一定要开,否则 Cookie 会在 HTTP 明文里传输。第三,如果你后面要做多实例,JWT_SECRET 必须在所有实例间一致,否则用户在 A 实例登录、在 B 实例被判定未登录。
验证隔离是否真的生效
配置完不要只看文档说”支持多用户”,自己动手验。
# 1. 创建两个测试用户 alice / bob
# 2. 用 alice 登录,拿到 token(具体命令以 CLI 帮助为准)
octop login --user alice
octop whoami

# 3. alice 建一个会话,发一条带特征的消息
octop chat "记住:我的项目代号是 NOVA-7"

# 4. 切到 bob,看能不能读到 alice 的会话
octop login --user bob
octop whoami
octop sessions list        # 不应出现 alice 的会话
octop chat "我的项目代号是什么"   # 应回答不知道

# 5. 直接查数据库确认数据行带了用户维度
sqlite3 ~/.octop/data/octop.db "select id, user_id, title from sessions limit 20;"
第 5 步是硬核验证:如果 sessions 表里没有 user_id 这一列,或者全都是同一个值,那所谓多用户隔离就只是”多个账号能登录”,数据层面并没有分开。这种情况在早期版本或者非官方分支上出现过,值得警惕。
多用户隔离的真实安全边界
我不喜欢把话说得太满,所以这里给出我认为最诚实的三条边界。
边界一:JWT 隔离防的是”误操作”,不是”恶意攻击者”
JWT + 按用户过滤,能保证 A 在正常使用中看不到 B 的数据。但如果攻击者已经能读你服务器上的 ~/.octop/,那所有用户的数据对他都是明文的——因为数据全在一个目录、一个数据库里。它不是一个跨租户加密的系统。所以 Octop 的部署边界应该是”你信任的机器 + 你信任的人”,而不是”对外开放注册的 SaaS”。
边界二:隔离的可靠性取决于每一条查询
行级隔离有一个固有的脆弱点:只要有一处代码忘了加用户过滤,就是一次越权。这跟独立数据库方案相比,风险是分散在各个查询里的。实践中我建议做两件事:第一,定期做交叉越权测试,用 B 的账号去尝试访问 A 的资源 ID;第二,对敏感操作(导出、批量删除、查看他人会话)单独加二次校验。
边界三:IM 渠道的绑定关系是隔离链上最弱的一环
JWT 本身很难伪造,但”谁对应谁”这个绑定是可以被搞错的。如果你的渠道配置成自动建号,且没有白名单,那么任何一个能给你机器人发消息的人都会获得一个合法账号。更麻烦的是,如果他恰好绑到了别人的身份上,那就是完整的越权。所以渠道侧的 bind_policy 必须收紧,这是我认为 Octop 部署中最容易被忽视的安全点。
访问控制与角色建议
| 角色 | 典型权限 | 能否看他人会话 | 能否配渠道 | 能否改模型密钥 |
|---|---|---|---|---|
| 管理员 | 全部 | 可(建议加审计) | 可 | 可 |
| 成员 | 自己的 Agent 与会话 | 不可 | 不可 | 不可 |
| 只读观察者 | 仅会话查看 | 不可 | 不可 | 不可 |
| 渠道机器人 | 仅消息收发 | 不可 | 不可 | 不可 |
小团队不用把角色做太细,三个够用了:一个管理员、若干成员、一个只读。真要把权限精细化,先确认你用的版本是否支持,别假设。
MBTI 人格模板:不只是玩梗
Octop 内置 MBTI 人格模板,很多人第一眼觉得这是个营销噱头。但如果你把它当成”人格即 Agent 配置模板”来用,会发现它其实解决了一个很实际的问题:如何让 Agent 的输出风格稳定可预期。
人格模板的本质是提示词工程的可复用单元
一个 MBTI 模板,拆开看就是一组约束:沟通风格、决策倾向、信息密度偏好、对外部反馈的敏感度。十六型人格正好覆盖了常见的几种工作风格组合,你不需要从零写系统提示词,选一个模板再微调就行。
举几个我实际用下来有效的组合:
- INTJ 型用做架构顾问:偏好结构化、直接给结论和取舍,不绕弯子。适合让它审方案。
- ENFP 型用做头脑风暴:发散、联想多、敢提不成熟的想法。适合让它陪你找灵感。
- ISTJ 型用做执行与核对:按流程走、紧盯细节、不发挥。适合让它做清单核对和数据整理。
- ENTJ 型用做项目推进:会主动拆任务、催进度、给优先级。适合放在 AgentTeams 里当协调者。
配置与自定义
# 查看内置人格模板
ls ~/.octop/personas/

# 复制一个模板作为基础,改成自己的
cp ~/.octop/personas/intj.json ~/.octop/personas/architect.json

# 自定义人格示例(在模板基础上补业务约束)
{
  "name": "architect",
  "base": "INTJ",
  "style": "结论先行,给出两到三个方案并说明取舍",
  "constraints": [
    "不确定的地方明确说不知道,不要编造",
    "涉及成本的话题必须给出数量级估算"
  ],
  "output_format": "先结论,再要点,最后风险"
}

# 改完重载
sudo systemctl restart octop
sudo journalctl -u octop -n 30 --no-pager | grep -i persona
人格模板的两个使用原则
原则一:人格决定风格,不决定能力
换了人格,模型还是那个模型,工具还是那些工具。别指望切到某个类型它就突然会写代码了。人格影响的是”怎么说”和”先关注什么”,不是”会不会”。理解这一点能避免很多失望。
原则二:不同人格之间的记忆要主动隔离
如果同一个用户跟两个不同人格的 Agent 各聊了很久,这两个 Agent 是不是共享记忆,取决于 Octop 的 Agent 配置,不取决于人格模板。多智能体场景下,记忆共享往往是个陷阱:让”头脑风暴 Agent”和”审核 Agent”共享上下文,两边很快会互相污染,输出越来越趋同。我在团队里实践的做法是协作类共享任务上下文、独立类不共享。
AgentTeams:多智能体协同实战
AgentTeams 是 Octop 区别于普通单 Agent 的核心能力。简单说,它让你把一个大任务拆给几个各有分工的 Agent,由其中一个负责统筹,最后合并输出。听起来像多 Agent 框架的标配,但 Octop 的实现放在单进程里,好处是没有跨进程通信开销,坏处是所有 Agent 抢同一个上下文窗口和同一份模型配额。
什么时候该用多智能体
先说结论:不是所有任务都值得拆多 Agent。 我见过太多人因为”多 Agent 听起来高级”就把一个普通任务拆成五个角色,结果成本和延迟翻了三倍,质量没有提升。判断标准就一条:任务里是否存在相互冲突的视角。
- 值得拆:方案评审(需要挑刺的视角和拍板的视角)、长文写作(需要结构视角和细节视角)、调研分析(需要搜集和核实两个角色)。
- 不值得拆:信息查询、格式转换、单次代码修改、日常问答。这些一个 Agent 做得更好,更快更便宜。
一个三人小队:调研 + 分析 + 写作
下面是我最常用的一个内部小队配置,解决”给一个陌生话题写一份带判断的简报”这类任务。
# 位置示意:~/.octop/agents/,实际字段以版本为准
{
  "team": "research-squad",
  "mode": "supervisor",
  "supervisor": "editor",
  "members": [
    {
      "id": "collector",
      "persona": "ISTJ",
      "role": "只负责收集事实,逐条给出来源,不做判断",
      "tools": ["web_search", "fetch"]
    },
    {
      "id": "analyst",
      "persona": "INTJ",
      "role": "基于事实给结论,明确区分事实与推断,标注置信度",
      "tools": []
    },
    {
      "id": "editor",
      "persona": "ENTJ",
      "role": "统筹流程、合并结果、对最终输出负责",
      "tools": []
    }
  ],
  "max_rounds": 3,
  "shared_context": ["task_brief"],
  "isolated_context": ["collector", "analyst"]
}三个设置值得展开讲。mode: supervisor 是指定一个统筹者,由它决定调用顺序和什么时候收尾,比自由协商好控制。 max_rounds: 3 是硬性上限,防止两个 Agent 陷入”你说得对我再补充”的无限循环——这在多 Agent 系统里是真实会发生的事。 shared_context 和 isolated_context 则明确了谁能看见什么。
运行、观察与调优
# 触发团队任务
octop run --team research-squad "整理一下开源 Agent 平台的演进路线,给出三条判断"

# 跟踪执行过程(另开一个终端)
sudo journalctl -u octop -f | grep -E "research-squad|collector|analyst|editor"

# 看这次任务的轮数与耗时,判断是否超预算
sqlite3 ~/.octop/data/octop.db \
  "select team, rounds, tokens, duration_ms from task_runs order by id desc limit 5;"
团队协作的三个真实陷阱
陷阱一:协调者吃掉了大部分预算
统筹者要读所有人的输出才能做决策。三个成员各产出 2000 字,协调者就要在上下文里装 6000 字再加自己的推理。Token 消耗不是线性增长,而是接近平方。控制手段是限制每个成员的单次输出长度,以及明确”只交结论不要交过程”。
陷阱二:人格差异被稀释
跑几轮之后你会发现几个 Agent 说话越来越像。这是上下文互相污染。解决办法就是上面提到的 isolated_context,让不同角色只共享任务简报,不共享彼此的完整推理过程。协调者只接受结构化摘要。
陷阱三:失败没有人兜底
某个成员调用工具失败,如果协调者不知道,它会把错误信息当成事实写进结论。这是多 Agent 最危险的地方——错误会被”合理地”包装。一定要在协调者的角色描述里写清楚:任一成员失败必须显式上报,不允许推测补全。
定时任务配置:让 octop run 真正 7×24 运转
Octop 内置的定时任务和系统 crontab 是两回事。系统 crontab 执行的是 shell 命令,Octop 的定时任务是进程内调度:到点后直接调用某个 Agent,产出结果推送到指定渠道。好处是不需要你写脚本、不用管鉴权、结果自动落到会话里。
创建第一个定时任务
{
  "name": "daily-brief",
  "enabled": true,
  "schedule": "0 8 * * *",
  "timezone": "Asia/Shanghai",
  "agent": "assistant",
  "persona": "ISTJ",
  "prompt": "汇总今天需要关注的三件事,控制在 200 字以内,只列要点不要寒暄。",
  "deliver_to": [
    { "channel": "feishu", "user": "alice" },
    { "channel": "telegram", "user": "123456789" }
  ],
  "on_error": "notify_admin"
}
# 不使用交互界面时,也可以用 CLI 触发一次(用于验证配置对不对)
octop task run daily-brief
# 查看任务列表与下次触发时间
octop task list
# 查看最近执行记录
octop task logs daily-brief --limit 10timezone 这一项千万别省。服务器默认是 UTC,写 0 8 * * * 你以为早上八点,实际是下午四点。这是我最常帮人排查的”定时任务时间不对”的原因,没有之一。
用系统 crontab 做兜底
进程内调度有一个固有限制:服务停了,任务就不会触发。所以我会额外配一个系统层的健康检查,服务挂了自动拉起,顺带检查关键任务有没有漏跑。
# 每 5 分钟检查一次服务状态,异常则重启
*/5 * * * * systemctl is-active --quiet octop || (sudo systemctl restart octop && echo "$(date) restarted" >> /home/octop/watchdog.log)

# 每天 9 点检查昨日 daily-brief 是否执行成功
0 9 * * * /home/octop/check-task.sh daily-brief >> /home/octop/task-check.log 2>&1
定时任务的资源纪律
因为定时任务和交互请求在同一个进程里,一个重量级的定时任务(比如每天早上一次性处理几百份文档)会把事件循环占满,用户在早上八点发现”AI 不回了”。经验做法:
- 重任务错峰,尽量排在夜间。
- 单个任务设产出上限,比如”最多处理 50 条”。
- 批量任务拆成多轮小任务,用
*/10分批推进,而不是一次性全量跑。 - 给定时任务单独绑定一个专用 Agent,必要时在配置里限制它的并发。
Octop 与单用户 Agent 的真实差异
这部分是写给已经用过单用户 Agent 的人的。很多人会问:我一个单用户的 Agent 也能接 IM,也能定时,凭什么要换?下面这张表是我用下来认为最实在的对比。
| 维度 | 典型单用户 Agent | Octop 多用户平台 | 部署上的实际差别 |
|---|---|---|---|
| 用户模型 | 一个主人,一个身份 | 多账号 + JWT 隔离 | 要规划建号、角色、绑定策略 |
| 会话隔离 | 靠话题/标签手动分 | 按用户自动隔离 | 要验证 user_id 维度真的生效 |
| 进程结构 | 常是单服务,IM 单独跑 | 单进程同起 Web/CLI/IM/定时 | 一条命令、一个 unit、一份日志 |
| 数据存储 | 散落在本地文件或各服务 | 统一在 ~/.octop/ |
备份策略简单,恢复快 |
| 多智能体 | 通常没有,或手写脚本调度 | 内置 AgentTeams | 要设计角色、上下文共享、预算上限 |
| 人格系统 | 自己写提示词 | 内置 MBTI 模板可扩展 | 可按角色分配人格,便于团队复用 |
| 扩展方式 | 加服务、加中间件 | 单进程内加渠道/加 Agent | 横向扩展需外置状态,成本高 |
| 故障影响面 | 影响一个人 | 影响全团队 | 必须配 systemd 托管 + 监控 + 备份 |
什么时候单用户 Agent 更合适
说句公道话,如果你只有自己一个人用,单用户 Agent 的部署成本更低、心智负担更小。多用户带来的账号体系、绑定策略、权限设计,在单人场景下全是纯开销。Octop 的价值在于它把”多人”这件事做成了一道开关,而不是默认复杂度。
什么时候必须上多用户
- 两个人以上共用一台机器上的 Agent,且不希望记忆互相污染。
- 需要按人分配模型预算和使用统计。
- 需要在一个 IM 群里让不同成员分别找 Agent 办事,各看各的结果。
- 需要多智能体分工,而单 Agent 的输出质量已经到瓶颈。
常见报错排查手册
下面是我在多次部署里反复遇到的报错,按出现频率排序。所有排错都建议先做同一件事:sudo journalctl -u octop -n 200 --no-pager,看清楚它到底死在启动的哪一步。
服务启动后立刻退出
最常见的原因有三个:端口被占用、数据目录无写权限、配置项缺失。逐个排查。
# 端口占用
sudo ss -lntp | grep -E ':8080|:443'
# 找到进程后确认是不是旧的 octop 实例
ps -ef | grep octop | grep -v grep

# 数据目录权限
ls -ld ~/.octop ~/.octop/data
# 应该属于 octop:octop;若属主是 root,说明之前用 root 跑过
sudo chown -R octop:octop ~/.octop

# 配置校验(如果版本支持)
octop config check 2>/dev/null || echo "该版本无 config check"
Web 能打开但页面一直转圈/频繁断线
九成是 WebSocket 没通。检查 Nginx 是否带了 Upgrade 头,以及 proxy_read_timeout 是否太短。用浏览器开发者工具的 Network 面板看 ws 连接状态,101 才算成功。
IM 渠道发消息完全没反应
按顺序验证:平台侧事件是否订阅 → 回调地址是否可达 → 服务日志是否收到请求 → 用户是否在允许列表 → 模型是否配通。这五步任一步断了,表现都是”没反应”。
# 从日志里追一条消息的完整链路
sudo journalctl -u octop --since "5 min ago" --no-pager | grep -iE "feishu|dingtalk|wecom|message|inbound"

# 如果日志里连 inbound 都没有,说明请求根本没到服务,问题在平台侧或反代
sudo tail -f /var/log/nginx/access.log | grep -i callback
消息能收到但回复发送失败
这是权限问题的典型症状。飞书多半是没开”发送消息”权限,钉钉多半是机器人未发布或未加入群,企微多半是应用可见范围没包含这个人。检查各平台的应用权限与可见范围,比看代码快得多。
用户说”我的对话被别人看到了”
这是最需要严肃对待的报错。先确认是不是渠道绑定错位:
sqlite3 ~/.octop/data/octop.db "select * from channel_bindings limit 50;"
# 看是否有两个不同的渠道 ID 绑到同一个用户名,或同一个渠道 ID 绑了多个用户名

# 再确认会话表是否真的按用户分
sqlite3 ~/.octop/data/octop.db "select user_id, count(*) from sessions group by user_id;"
如果绑定没问题、会话也确实按用户分,那大概率是多渠道共用了同一个默认 Agent 且共享了记忆。检查 Agent 配置里的上下文共享范围。
定时任务到点没触发
先查时区,再查服务是否在那段时间重启过,最后查任务是否被禁用以及上次执行是否报错。
timedatectl        # 看系统时区
octop task list    # 看 enabled 与下次触发时间
octop task logs daily-brief --limit 5
内存持续上涨最终被杀
# 观察内存曲线
sudo systemctl status octop --no-pager | grep Memory
ps -o pid,rss,vsz,etime,cmd -C node 2>/dev/null

# 看是不是 OOM 被杀
sudo journalctl -k --since "1 day ago" | grep -i "out of memory"

# 对策:限制长会话上下文、定期归档老会话、把 uploads 清理策略配起来
du -sh ~/.octop/* | sort -h
风险提示与上线检查清单:交付同事前必过的八项
部署完不要急着交给同事用,先按下面这张表过一遍。每一项都对应后文 FAQ 里提到的一类事故。
| 检查项 | 验证方式 | 不通过的后果 |
|---|---|---|
| service 已 enable 且随开机启动 | systemctl is-enabled octop |
服务器重启后全站不可用 |
| JWT_SECRET 已更换为随机值 | 检查环境变量文件 | 身份可被伪造 |
| HTTPS 与 WebSocket 已通 | 浏览器 ws 101 | 页面频繁断线 |
| 两个用户数据隔离已验证 | 交叉测试 | 会话串台 |
| 渠道 bind_policy 已收紧 | 查看 channels 配置 | 外人白嫖额度 |
| 备份脚本可跑通且恢复过 | 实际恢复一次 | 出事时备份不可用 |
| 定时任务时区正确 | timedatectl + 试跑 |
任务时间全错 |
| 内存上限已配置 | MemoryMax |
OOM 静默重启 |
回头看,Octop 这套设计最聪明的地方,是把”多用户”和”多智能体”从”部署复杂度”里挪了出去。一条 octop run 背后是单进程、单一数据目录、单一身份体系,部署者省下来的时间可以全部花在真正有价值的事情上:设计 Agent 的分工、调人格、写定时任务、想清楚权限边界。
但我也想留一句提醒。单进程换来的简单是真实的,天花板也是真实的。当你的团队从 5 人变成 50 人,先要去动的不是机器配置,而是数据外置与任务拆分。提前知道这条线在哪,比事后重构便宜得多。
至于多用户隔离,我的态度一直很明确:它是一个优秀的”防误操作”机制,不是一个”抗攻击”机制。你把它当成后者来用,迟早会出问题;当成前者,它足够可靠,而且部署起来真的很省心。
常见问题
问:octop run 一条命令同时起四种服务,是真的同进程还是背后起了多个子进程?万一一个崩了会不会全挂?
是真的同进程。Web 控制台、CLI、IM 接入、定时任务共享一个事件循环、一份数据目录、一套身份体系,这也是它能用一条命令启动的根本原因。所以”一个崩了全挂”这个担心是成立的——它们本来就是一体的。应对方式不是去拆,而是用 systemd 托管(Restart=on-failure)让它在异常退出后自动拉起,再加一个 crontab 看门狗做二次兜底。真正需要拆分的是当团队规模大到一个进程扛不住的时候,那时要动数据层和调度锁,而不是简单地多起几个 octop run。
问:我用 root 装好、又用普通用户启动,结果配置全空了,数据去哪了?
两套数据目录各自为政。Octop 的数据目录是 ~/.octop/,~ 取决于启动进程的用户。root 启动时是 /root/.octop/,octop 用户启动时是 /home/octop/.octop/。解决办法:先执行 ls -la /root/.octop 确认旧数据在不在,停服务后把内容覆到 /home/octop/.octop/,再 chown -R octop:octop ~/.octop,最后重启。做 Octop 部署时,从一开始就统一用专用用户操作,可以完全避免这个问题。
问:飞书/钉钉的回调地址验证一直失败,日志里什么都看不到,怎么查?
先区分是”请求没到”还是”到了但处理失败”。用 curl 直接 POST 到你的回调路径,看返回码;同时 tail -f /var/log/nginx/access.log 看有没有这条记录。没有记录就是反代或防火墙的问题,有记录但 Octop 日志没有就是路径没对上。飞书常见的坑是权限未开全、事件未订阅;钉钉常见的是回调地址末尾斜杠不一致、AES Key 不是 43 位。企微还要额外完成可信域名校验,这一项没做,回调会一直不通。
问:多用户隔离到底有多安全?我把账号发给外部朋友用合适吗?
取决于你指的是哪种安全。对”误操作”它是可靠的:按用户过滤的数据访问,加上 JWT 上下文,能保证正常使用中 A 看不到 B 的会话。对”恶意攻击”它不构成防线:所有用户数据存在同一个 ~/.octop/ 目录、同一个数据库里,能碰到服务器的人可以读全部数据;行级隔离在代码层面天然有”漏一处就破防”的脆弱性;IM 渠道绑定如果配错还可能造成身份错位。所以我的建议是:Octop 部署的边界划在”你信任的机器、你信任的人”,给外部人开账号之前,先把 bind_policy 收成白名单,并做一次交叉越权测试。
问:AgentTeams 跑起来 token 消耗特别大,有什么实际的控制办法?
三个手段,按效果排序。第一,限制成员输出长度,要求”只交结论不交过程”,这一条往往能省一半。第二,限制 max_rounds,三轮足够大多数任务收敛,超过三轮通常说明任务定义有问题。第三,把成员上下文隔离,只共享任务简报,不共享彼此完整推理。另外协调者的上下文是最贵的,因为它要读所有人的输出,所以尽量给它结构化摘要,而不是全文。最后记得定期看 task_runs 表里的轮数和 token 数,别让 AgentTeams 悄悄变成预算黑洞。
问:~/.octop/ 直接 tar 打包备份可以吗?为什么建议加密?
不建议直接 tar,原因是 SQLite 数据库在写入过程中打包可能拿到不一致的快照,恢复后出现数据损坏或丢失,而且 WAL 文件如果没一起带上,最近的写入就没了。正确做法是用 sqlite3 ... ".backup" 做在线备份,再把纯文件目录复制走。加密是必须的,因为 channels/ 和 secrets/ 里存着各 IM 平台的 App Secret、Bot Token 以及 JWT 密钥,一份明文备份泄露,等于把你全平台的机器人都交出去了。恢复时记得 chown -R 修正属主,否则服务会因为没有写权限而起不来。






暂无评论内容