

通义千问 Qwen 本地剧本生成 + ComfyUI 批量渲染:消费级显卡跑通”文字故事→漫剧成片”
做漫剧(AI漫画剧、动态漫画短剧)的创作者,十有八九卡在同一个地方:剧本和分镜提示词的生成成本。用云端大模型,写一集剧本烧一次额度,改稿十次烧十次,风格还时好时坏;数据传到第三方服务器,对商业项目来说也是隐患。而另一头,ComfyUI 已经把绘图侧的批量化做得很成熟——缺的其实是”上游”:一个稳定、可无限次调用、风格可固化的剧本与提示词工厂。
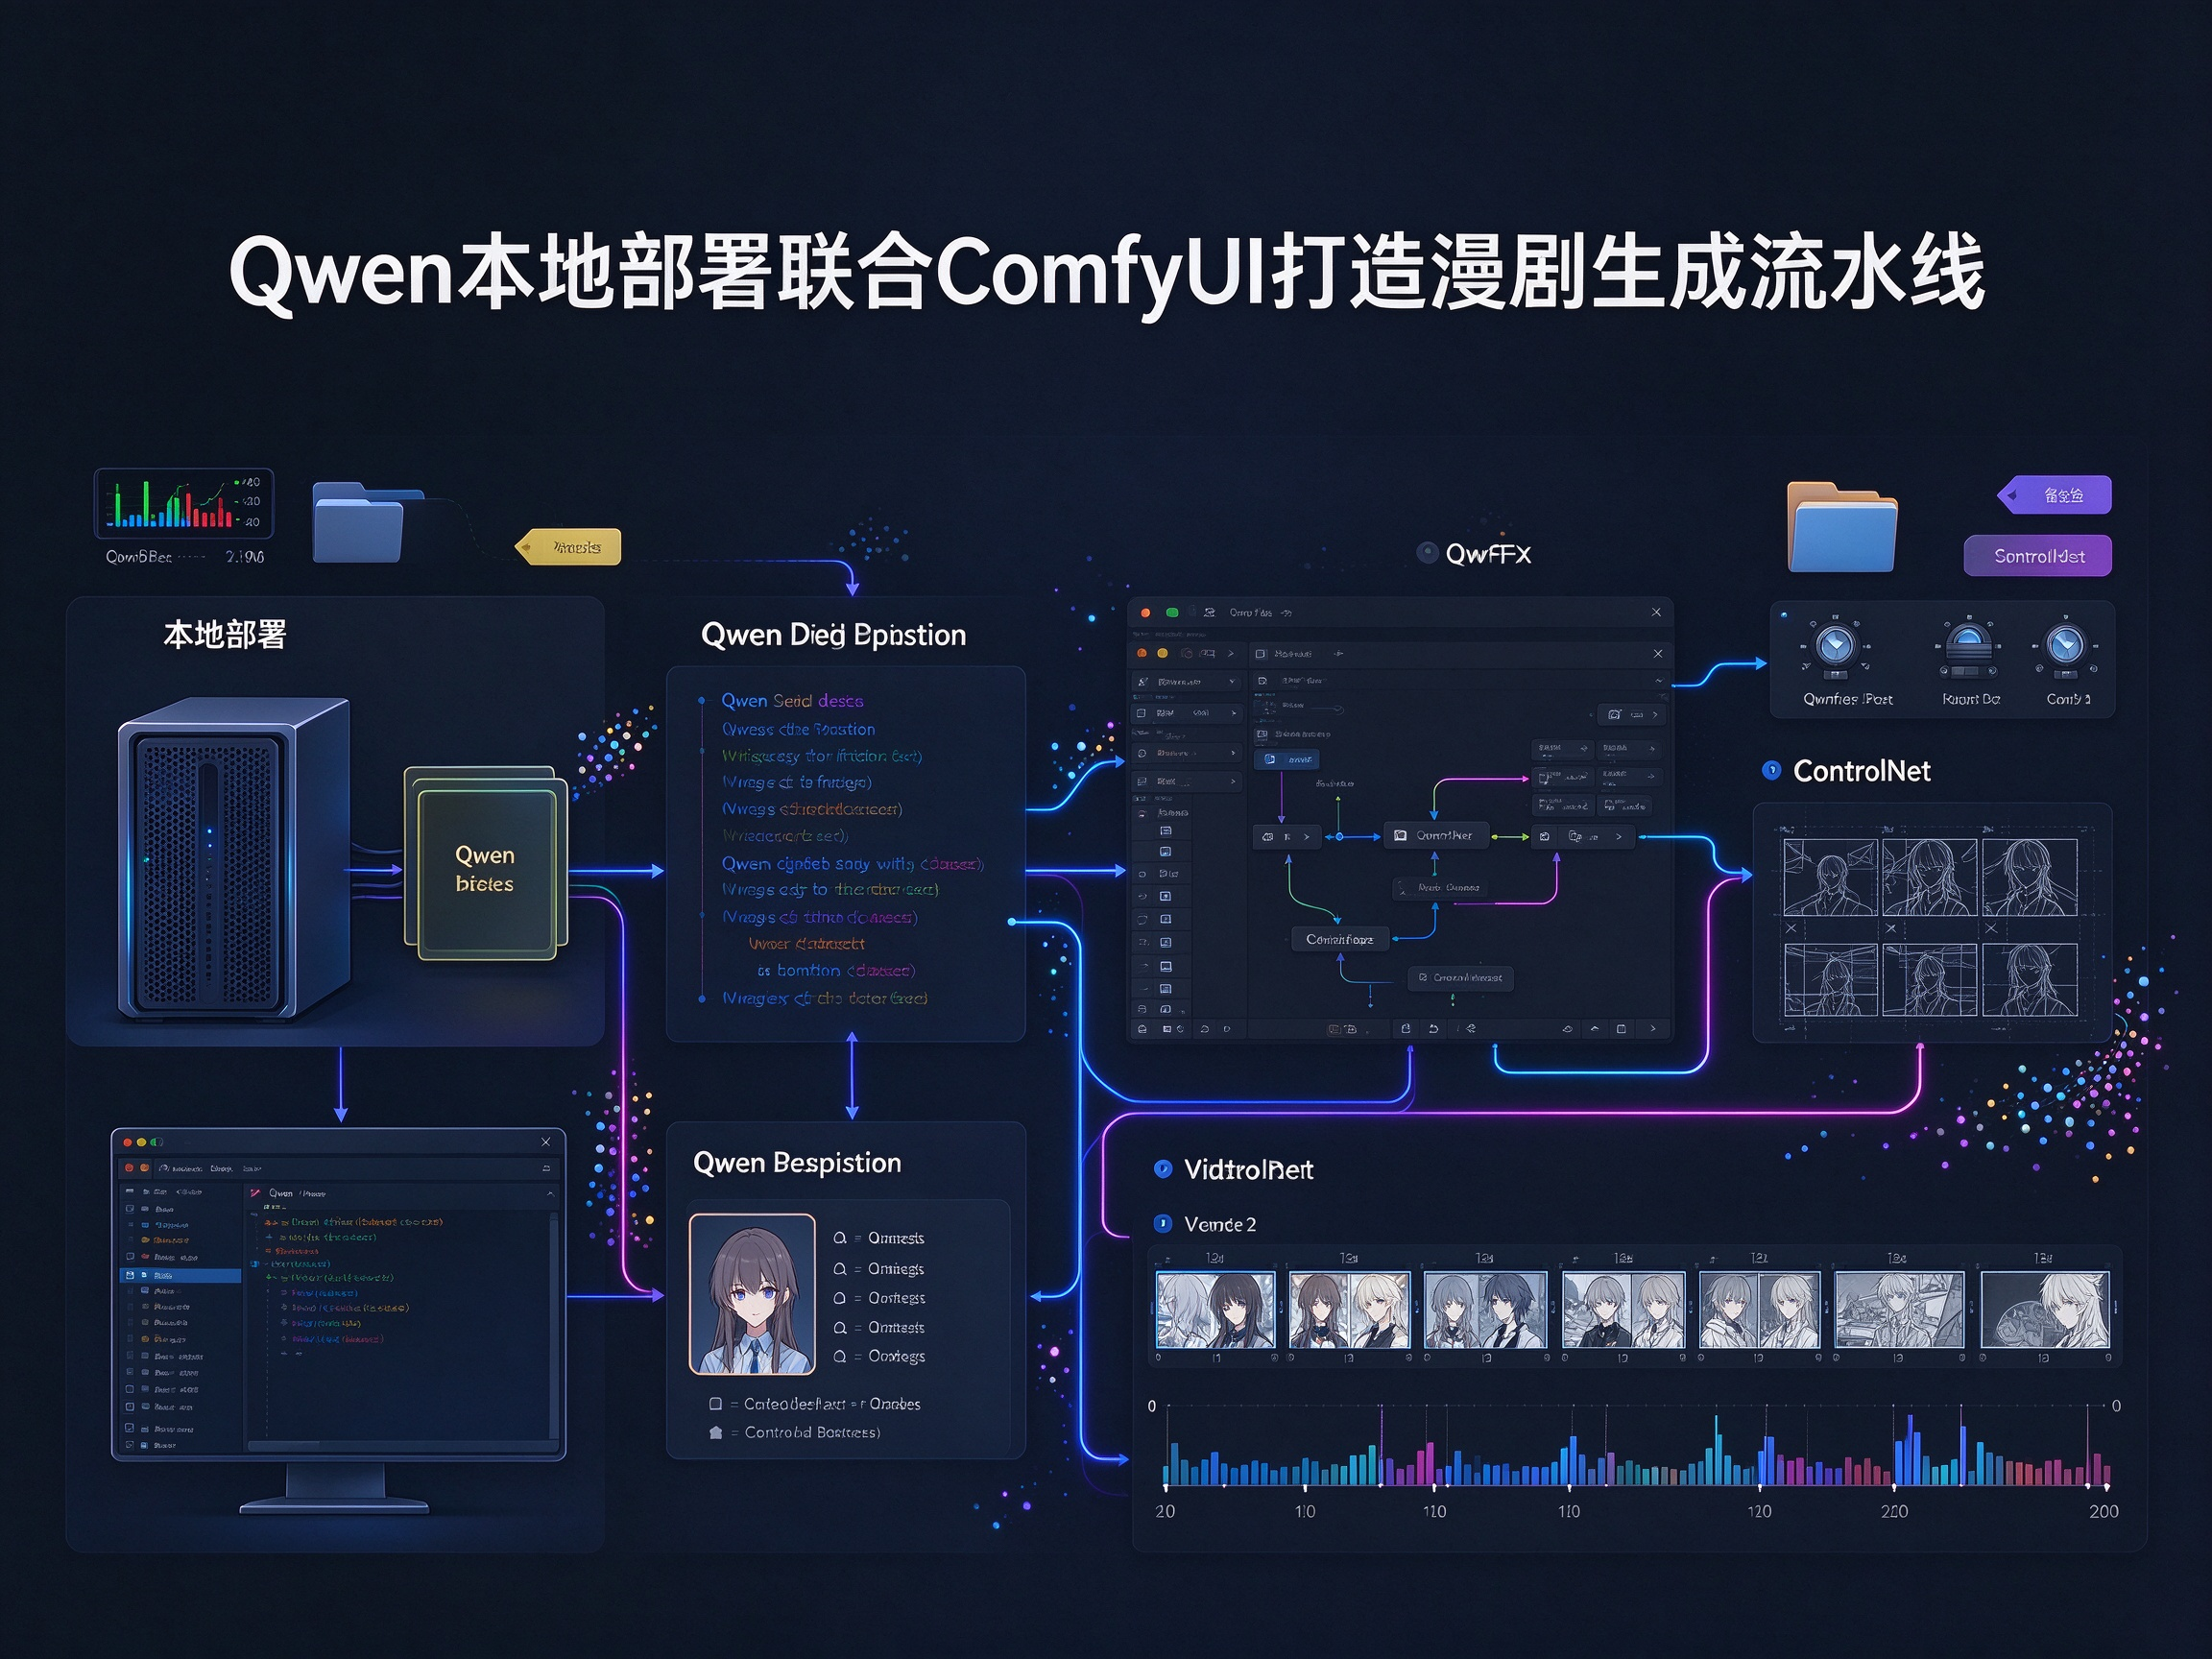
本文给出的方案是:把阿里通义千问 Qwen 系列开源模型量化后部署在本机,让本地 LLM 负责”文字故事→分镜JSON”,再由 ComfyUI 批量渲染成图、图生视频、组装成片。8-16GB 显存的消费级显卡就能跑通完整链路——前提是你接受”串行执行”的纪律。下面从选型、部署、模板、JSON 结构、批量队列、显存管理到成片组装,一步步展开。
一、为什么剧本生成本地化是漫剧流水线的正确起点
1.1 云端 API 的三个隐形天花板
云端 API(如 DashScope 上的 Qwen 商业版)单价确实便宜,看似按次付费很划算。但放到漫剧生产语境下,问题会逐渐暴露:
第一,试错次数被货币化。一集漫剧的分镜提示词,从初稿到可用版本平均要迭代 5-10 轮。云端每轮都计费,而且你在调提示词模板时,往往要整批重跑几十个分镜才能看出风格偏移——这是隐形成本的大头。
第二,随机性不可控。多数云端 API 不保证固定 seed 的可复现性,同一段提示词今天和明天出的结果可能措辞、风格描述都不同。漫剧需要的是”第3集的画风和第1集一致”,这要求生成过程本身可复现。
第三,数据出本机。未发布的剧本、角色设定集、世界观文档,全部要发给云端才能生成。对签约项目或原创 IP 来说,这不是可以忽略的小事。
1.2 本地部署的真正价值:不是省钱,是无限次试错
这里要给出一个可能和你直觉相反的判断:本地化 Qwen 的核心价值不是省 API 费,而是把”试错”变成零边际成本的行为。
当你能在本机上对着一份剧本模板跑 200 次而不心疼时,你的创作方式会改变:你会真的去测试”分镜描述里先写景还是先写人,出图构图更稳””把角色发色写进 system prompt 和写进 user prompt,一致性差多少”。这些经验只有靠大量廉价实验才能积累,而云端按次计费天然抑制这种实验。
第二个被低估的价值是可复现性:本地推理时固定 temperature、固定随机种子、固定量化版本和模型权重,同一份输入基本能得到同一份输出。这对漫剧这种”跨集一致性”要求极高的内容形态是决定性的——你可以把某一次调得非常好的剧本输出”锁住”,之后只改动剧情变量。
当然,也要诚实面对代价:本地模型的上限不如旗舰云端模型,长篇剧情编排能力弱一档,速度受限于你的显卡。所以合理的策略是混合使用——后面第 7 节会展开。
1.3 全链路鸟瞰
先给整条流水线的地图,后文逐段拆解:
① 本地 Qwen(Ollama / LM Studio 部署)读入故事大纲和人设卡 → ② 输出结构化分镜 JSON → ③ Python 脚本解析 JSON 为提示词队列 → ④ ComfyUI 批量渲染分镜图(固定种子 + IP-Adapter 保一致性)→ ⑤ 图生视频(每个分镜转 2-4 秒动态镜头)→ ⑥ 按剧本顺序拼装、配音配乐、输出成片。
其中 ①②③ 完全离线,④⑤⑥ 也在本机完成。整条链路里只有”你决定要联网”的部分才联网。
二、Qwen 模型选型:不同尺寸怎么选
Qwen(通义千问)开源了多个尺寸的模型,从适合 CPU 的 1.5B/4B,到主流消费级显卡能跑的 7B/14B,再到需要多卡或高端单卡的 32B。选型的核心矛盾是:剧本理解能力 vs 显存预算。
2.1 尺寸对照表
| 模型规格 | 典型显存需求(4bit量化) | 剧本能力评价 | 适用场景 | 建议硬件 |
|---|---|---|---|---|
| Qwen 4B 级 | 约 3-4GB | 能写短对话和简单提示词,长剧情容易跑偏 | 分镜提示词的二次润色、批量小改写 | 8GB 显卡 / 甚至纯 CPU |
| Qwen 7B 级 | 约 5-6GB | 能产出结构化分镜 JSON,复杂剧情需要人工补拍 | 8GB 显存机器的主力,短剧单集生产 | RTX 3060 8GB / 4060 |
| Qwen 14B 级 | 约 9-11GB | 剧情编排、角色对白质量明显上一档,JSON 稳定性更好 | 16GB 显存机器的主力,推荐漫剧生产首选 | RTX 4080 / 4090 移动版 |
| Qwen 32B 级 | 约 18-20GB 起 | 接近旗舰云端的剧情理解与长文一致性 | 有 24GB 显卡或愿意部分 CPU offload 的进阶用户 | RTX 3090 / 4090 24GB |
给一个直接的建议:8GB 显存从 7B 量化版起步,16GB 优先上 14B,不要因为”32B 更聪明”就硬塞——32B 在 16GB 卡上需要 CPU offload,速度会掉到不可用的程度,整批分镜生成的时间反而超过小模型多轮迭代。
2.2 量化版本的选择逻辑
量化(如 4bit)是把模型权重压缩到低位宽以减少显存占用,代价是轻微的精度损失。实操中:
• 8GB 卡:选 Q4_K_M 之类的 4bit 量化,7B 模型占 5GB 左右,留出上下文缓存空间;
• 12-16GB 卡:同样用 4bit 但可以上 14B,或者用 6bit 量化跑 7B 换取更好的对白质量;
• 不要追求 8bit 甚至原版精度:剧本生成任务对量化不敏感,4bit 和 8bit 产出的分镜 JSON 质量差异远小于提示词模板本身的差异。
• 上下文长度按需开:一集漫剧的剧本 JSON 大约 3000-6000 token,加上人设卡和模板指令,建议上下文开到 8K-16K。开太大同样吃显存。
2.3 部署工具对比:Ollama vs LM Studio
| 维度 | Ollama | LM Studio | dashscope 云端 API |
|---|---|---|---|
| 形态 | 命令行为主,有 REST 接口 | 图形界面 + 本地服务器 | 联网 API |
| 上手难度 | 一条命令拉模型,适合写脚本 | 可视化选模型调参数,零命令行 | 最低,但要联网和 API Key |
| 批量化友好度 | 极高,天然适合接 Python 流水线 | 中等,也有 OpenAI 兼容接口 | 高但计费 |
| 数据隐私 | 完全本机 | 完全本机 | 数据出本机 |
| 成本 | 免费 | 免费 | 按 token 计费 |
| 适合人群 | 要接 ComfyUI 流水线的技术型创作者 | 想先手动调好模板再自动化的创作者 | 需要旗舰模型上限的最终成稿环节 |
本文主推 Ollama,因为它默认暴露 OpenAI 兼容的本地 HTTP 接口,和后文的 Python 队列脚本无缝衔接。LM Studio 适合你在调参阶段用 GUI 反复试温度和提示词,调好了再切到 Ollama 做批量。
三、本地部署步骤概述:从零到剧本可用
3.1 第一步:安装 Ollama 并下载模型
到 Ollama 官网下载对应系统的安装包(Windows/macOS/Linux 都有),安装后在终端验证:
ollama --version
然后拉取 Qwen 模型(以 14B 的 4bit 量化版为例,具体 tag 以官方模型库页面为准):
ollama pull qwen3:14b
下载完成后先做一次冒烟测试:
ollama run qwen3:14b "你是一个漫画编剧,请用一句话概括一个复仇故事"
如果回复正常、速度可接受(14B 在 16GB 显卡上一般每秒 10-20 token),就可以进入下一步。
3.2 第二步:确认量化与显存占用
用 ollama show qwen3:14b 查看模型参数与量化等级。启动后可以打开任务管理器(或 nvidia-smi)确认模型已驻留显存。如果你的卡是 8GB,请换成 7B 系列 tag;如果显存吃紧,可以在 Ollama 的配置中限制上下文长度(num_ctx),从 8192 起步。
3.3 第三步:让模型常驻服务化
Ollama 安装后默认就在本机 11434 端口提供 HTTP 服务。建议后续所有调用都走 API 而不是交互式命令行,这样参数(temperature、seed、system prompt)可以精确控制并写进脚本固化。关键参数:
• temperature: 0.7(剧情生成);写分镜 JSON 时降到 0.3-0.5,结构更稳;
• seed:固定一个数字(如 20260101),保证同样输入可复现;
• num_ctx:8192 起步,人设卡很长时提到 16384。
3.4 提示词模板的调优方法:如何科学地试错
有了无限次免费的生成能力,接下来要解决的是”怎么试才有效”。漫剧创作中最浪费时间的不是生成失败,而是无效试错——改了十个词,出图质量没有方向性的变化。给你一套被验证过的调优顺序:
第一步,先锁结构再锁风格。让 Qwen 稳定输出合法 JSON 是第一优先级,这个阶段不要管文采。用固定的 5 个测试大纲反复跑,统计 JSON 一次解析通过率,低于 90% 就继续收紧模板措辞(例如把”只允许:远景/中景/近景/特写”改成逐字段给枚举并加”违反视为无效输出”的强约束)。
第二步,人设注入位置实验。把角色外貌分别放在 system prompt、user prompt 开头、user prompt 结尾三个位置各跑一批,对比下游出图的角色一致率。多数情况下”user prompt 开头 + prompt_keywords 强制复述”的组合最稳,但这依赖于你的具体模型版本,值得亲手验证。
第三步,景别词映射实验。让 LLM 自由发挥景别描述,往往会出现”半身微俯视带环境虚化”这类绘图模型无法理解的词。在模板里限定为四个枚举值后,你在 ComfyUI 侧为每个景别配一套构图参数(分辨率、IP-Adapter 权重、镜头角度关键词),整个链条的可预期性会大幅提升。
每次实验只改一个变量,并把结果记进一份简单的表格(日期、变量、通过率、观感评分)。本地试错的价值要靠记录才能兑现——跑了两百次但没有笔记,等于白跑。
3.5 显存预算的残酷现实:先说清串行原则
这里必须先打预防针:8-16GB 显存可以同时装下量化 Qwen 和 SDXL 轻量绘图流程吗?理论勉强,实践不要。SDXL 出图本身就吃 6-8GB,加上 LLM 的 5-11GB,16GB 卡必然溢出,8GB 卡直接爆炸。所以本文方案的铁律是:
先跑 LLM 生成全部分镜 JSON(此时不碰 ComfyUI),跑完后卸载/释放 LLM 显存,再启动 ComfyUI 批量出图。串行执行,绝不同时。这是消费级硬件上唯一稳定的姿势,第 6 节会给出具体操作。
四、剧本生成:提示词模板与分镜 JSON 结构
4.1 人设事实卡:一切一致性的地基
在写模板之前,先建立一个观念:剧本质量和出图质量要用同一套”人设事实”来约束。LLM 写对白时如果把女主的”银发红瞳”写丢,下游 ComfyUI 就算用 IP-Adapter 也救不回来——因为提示词里根本没有这个信息。所以你要维护一份唯一事实源(人设卡 JSON),同时注入 LLM 的 system prompt 和 ComfyUI 的提示词模板。
人设卡示例(保存为 characters.json):
{ "roles": [ { "id": "heroine", "name": "林晚", "age": 22, "hair": "银白色长发", "eyes": "红瞳", "outfit": "黑色风衣+白色围巾", "personality": "外冷内热,说话简短", "props": ["旧怀表"] } ], "style": "赛博朋克都市,冷色调,霓虹雨夜", "negative": "低质量,多余手指,文字水印" }
4.2 剧本生成提示词模板(可直接套用)
下面这个模板经实测对 7B/14B 量化版都稳定。核心技巧有三:给输出格式立死规矩、给 JSON 字段逐一定义、给”不允许出现的事”列黑名单。
【System】你是一名漫画剧分镜编剧。你只输出 JSON,不输出任何解释、寒暄或 markdown 代码块标记。

【User】请根据以下信息生成分镜剧本:

一、人设事实(必须严格遵守,不得自行修改外貌设定):{characters_json}

二、本集大纲:{episode_outline}

三、要求:

1. 输出 JSON,顶层结构为 {"episode": 序号, "shots": [ ... ]}

2. 每个分镜对象包含字段:shot_id(整数,从1递增)、scene(场景描述,15字内)、character(出场角色id,多人用逗号分隔)、action(动作与情绪,30字内)、dialogue(对白数组,每人一句,可为空数组)、camera(景别,只允许:远景/中景/近景/特写)、prompt_keywords(给绘图模型的英文关键词短语,必须包含角色发型、瞳色、服装、场景、光线风格,40词以内)

3. 分镜数量 8-12 个

4. 禁止:外貌设定与事实卡冲突;dialogue 中出现旁白;prompt_keywords 中出现人名中文;出现分镜数外的额外字段

四、本集大纲内容:{outline}
几个实战细节:prompt_keywords 要求”必须包含角色发型瞳色服装”是关键——它把人设事实直接压进了绘图提示词,跨分镜一致性从这里来。camera 字段限定枚举值,是为了后文 ComfyUI 里按景别映射不同构图模板。temperature 建议先用 0.4,如果 JSON 频繁解析失败就降到 0.2。
4.3 分镜 JSON 字段结构详解
一份合格的输出长这样(节选两个分镜):
{ "episode": 3, "shots": [ { "shot_id": 1, "scene": "雨夜天台", "character": "heroine", "action": "林晚背对镜头眺望城市,握紧怀表", "dialogue": ["十年了。"], "camera": "远景", "prompt_keywords": "1girl, silver long hair, red eyes, black trench coat, white scarf, rooftop at rainy night, neon city lights, cinematic, cold color" }, { "shot_id": 2, "scene": "天台边缘", "character": "heroine", "action": "林晚转身,眼神冷峻", "dialogue": ["该收账了。"], "camera": "近景", "prompt_keywords": "1girl, silver long hair, red eyes, black trench coat, upper body, cold expression, neon rim light, rainy night, cinematic" } ] }
每个字段在流水线里的用途:shot_id 用于文件命名和排序,保证成片组装顺序不错乱;scene+camera 用于映射 ComfyUI 的构图与景别模板;dialogue 走 TTS 生成配音;prompt_keywords 是喂给绘图模型的主体,action 里如果有重要视觉信息(如”握紧怀表”),应该手工补进关键词——这是目前 LLM 到绘图之间唯一值得人工过目的环节。
4.4 JSON 解析的容错处理
量化小模型偶发会输出尾随逗号或代码块标记。Python 侧建议做三层容错:先尝试直接 json.loads;失败则用正则剥掉 “`json 包裹再试;再失败则把原文回喂给 Qwen 一次,附一句”修复以下 JSON 并只输出 JSON”。三层都失败才标记该集需人工处理。实测 14B 模型按 4.2 模板跑,一次通过率通常在九成以上。
五、ComfyUI 批量渲染:提示词队列与一致性控制
5.1 ComfyUI 为什么适合批处理
ComfyUI 的节点式工作流可以保存为 JSON API 文件,通过 HTTP 接口(/prompt)提交队列,非常适合脚本驱动。相比手点 GUI,你可以让一份工作流吃进整条提示词队列,一晚上自动跑完一集 12 个分镜。
5.2 批量队列的三种实现方式
方式一:提示词列表节点。社区有 prompt list / batch 类节点(如效率节点包里的列表批处理节点),把多行提示词文本粘进节点,工作流按行迭代出图。适合临时跑一批,改词要回 GUI。
方式二:外部脚本 + API 提交(推荐)。Python 读分镜 JSON,逐条替换工作流 JSON 里正向提示词节点的 text 字段,POST 到 http://127.0.0.1:8188/prompt,ComfyUI 自动排队串行出图。脚本还能顺便接管文件命名(用 shot_id)和历史记录,是最可控的方式。
方式三:ComfyUI 原生 Batch Count。只是同一个提示词重复 N 次,用于同分镜抽卡挑图,不用于多分镜批量。
5.3 工作流搭建要点(SDXL 轻量流程)
8-16GB 显存建议的基线工作流:SDXL 1.0 底模(或同量级的动漫向 SDXL 模型)+ DPM++ 2M Karras 采样器 + 25-30 步 + 分辨率按景别分档(远景 1216×704,近景/特写 832×1216)。显存优化开 –medvram 或低显存模式,8GB 卡可稳定出 SDXL 图。
一致性靠三件事叠加:
• 固定种子策略:整集共用一个基础种子,shot_id 做微偏移(如 base_seed + shot_id),既保证同集风格聚拢,又避免每个分镜构图完全雷同;
• IP-Adapter 锁角色:给每个角色准备 2-3 张定妆图作为 IP-Adapter 参考图,权重 0.6-0.8,跨分镜人脸与服装的稳定性远好于纯文字描述;
• 统一的 LoRA 与风格词:画风 LoRA 全集统一加载,负面提示词从人设卡的 negative 字段全局注入。
5.4 图生视频与成片组装
分镜图出来后,图生视频环节(如基于 SDXL 的视频工作流或 AnimateDiff 类节点)给每张图加 2-4 秒的镜头动态:远景加缓慢推镜,特写加头发飘动和雨丝。这一步同样在 ComfyUI 里批量跑,队列逻辑与出图相同。最后用 ffmpeg 或剪辑软件按 shot_id 顺序拼接,对齐 TTS 配音的时长做微调,成片即出。ffmpeg 拼接示例:
ffmpeg -f concat -safe 0 -i shots.txt -c:v libx264 -pix_fmt yuv420p episode3.mp4
六、串行执行的显存管理:消费级硬件的生存法则
6.1 为什么串行优于并行
一个常见的误区是”我 16GB 显存,能不能 LLM 常驻、ComfyUI 随用随调?”答案是不要。原因有三:
第一,显存溢出后系统会做 CPU 回退或直接 OOM 崩溃,一次崩溃可能丢掉整批队列进度。第二,即便勉强共存,两个大模型来回换入换出显存,速度比各自独占跑完慢得多——显存搬运本身就是开销。第三,出问题你无法定位是 LLM 幻觉还是绘图显存不足导致的降级。
所以我的判断是:串行流水线不是消费级硬件的妥协,而是它的最优解。LLM 生成 12 个分镜可能只要几分钟,ComfyUI 出图才是真正耗时长(每图 20-60 秒)的环节,两者的峰值时间本来就错开,串行几乎不损失吞吐。
6.2 具体的串行操作流程
① 确认 ComfyUI 未运行,nvidia-smi 确认显存占用接近 0;
② 启动/唤醒 Ollama,跑剧本生成脚本,产出全部分镜 JSON;
③ 剧本全部生成并解析校验通过后,ollama stop qwen3:14b(或直接结束 ollama 进程)释放显存,再次 nvidia-smi 确认清空;
④ 启动 ComfyUI(低显存模式),提交整批出图队列;
⑤ 出图完成后如需图生视频,ComfyUI 继续接管;如需回头改剧本,先停 ComfyUI 再唤 LLM。
可选的自动化:用 Python 脚本把②③④串成一条命令,中间加 subprocess 控制 Ollama 的启停。多集连跑时尤其值得——睡前提交 5 集任务,早上收 5 集成片。
6.3 显存管理清单
• 8GB 卡:7B 4bit + SDXL medvram,串行,上下文 8K;
• 12GB 卡:14B 4bit 或 7B 6bit + SDXL 低显存模式;
• 16GB 卡:14B 4bit + SDXL medvram,上下文可开 16K;
• 通用纪律:浏览器、壁纸引擎等吃显存的程序在跑队列时关掉;nvidia-smi 是你的仪表盘,每次阶段切换看一眼。
七、混合方案与替代路线
7.1 三种方案对比
| 维度 | 全本地(Qwen本地 + ComfyUI本地) | 全云端(云端LLM + 云端绘图) | 混合(本地出图 + 云端出文) |
|---|---|---|---|
| 成本结构 | 电费+硬件折旧,边际成本趋近于零 | 按次计费,批量试错成本线性增长 | 出图免费,出文小额计费 |
| 可复现性 | 种子+量化版本可完全锁定 | 基本不可控 | 出图可控,剧本半可控 |
| 质量上限 | 受模型尺寸限制,14B 够用但非旗舰 | 旗舰模型,剧情上限最高 | 剧本用旗舰,出图用本地,上限较高 |
| 隐私 | 完全离线 | 全出本机 | 剧本出本机 |
| 硬件门槛 | 8-16GB 显存起步 | 无 | 需 8GB+ 显存 |
| 适合人群 | 批量生产、IP 长线开发、重视试错 | 轻量尝鲜、无独显用户 | 有显卡但要旗舰剧本质量的团队 |
7.2 混合方案的落地建议
如果你的卡只够跑 7B,而某几集剧情复杂(多线叙事、反转密集),可以只把”大纲→分集大纲”这一步交给云端旗舰,”分集大纲→分镜 JSON”仍用本地 Qwen——因为分镜 JSON 是格式化任务,小模型胜任,而剧情架构才真正考验模型上限。这样云端调用次数从”每分镜一次”降到”每集一次”,成本几乎可以忽略,同时保留了本地的批量化与可复现优势。
八、生产化细节:目录组织、命名与质检节点
8.1 项目目录结构建议
流水线一长,文件管理混乱是常见的翻车点。建议每部漫剧一个根目录,固定如下结构:
project/

├─ characters.json      # 唯一人设事实源

├─ outlines/ep03.md     # 分集大纲

├─ scripts/ep03.json    # Qwen 生成的分镜剧本

├─ images/ep03/shot01.png … shot12.png

├─ videos/ep03/shot01.mp4 …

├─ audio/ep03/shot01.wav …   # TTS 配音

└─ final/ep03.mp4
命名规则用 episode + shot_id 零填充(shot01 而不是 shot1),这样 ffmpeg 的 concat 列表和任何批量脚本都不会排序错乱。人设卡一旦改动要升版本号(characters_v2.json),并在剧本 JSON 里记录使用的人设卡版本——否则一个月后你对着崩坏的角色脸,无法追溯是哪次改动引起的。
8.2 两个必须保留的人工质检节点
全自动流水线很容易让人想省掉所有人工环节,但有两处值得保留人眼:
第一,剧本质检:出图之前花两分钟通读分镜 JSON,重点核对 action 与 prompt_keywords 是否覆盖了本镜的关键视觉信息、对白是否符合角色口吻。在图出来之前改一行文字的成本,是图出来之后重跑的三分之一。
第二,首镜定妆质检:每集先单独渲染 shot01,确认角色脸、画风、构图合格后再提交整批队列。如果首镜就崩了,整批跑完也是废片。这个”先跑一镜、通过后跑全批”的习惯,能把废批率压到最低。
8.3 配音与节奏的对齐
TTS 生成的对白音频时长往往和 2-4 秒的镜头长度不匹配。两个解法:其一,先量出每句配音时长,再决定图生视频的目标秒数,让镜头迁就声音;其二,在 ffmpeg 拼接时用 tpad 或慢放把镜头拉长到配音结束。前者更符合漫剧的观感节奏——观众读字幕和听对白的时间决定镜头寿命,而不是反过来。
九、独到见解:三个反直觉的判断
判断一:本地化的真正价值不是省钱,是无限次试错。本文 1.2 节已展开,这里补一个数字感受:调一套稳定的分镜提示词模板,典型需要 100-300 次完整生成实验。按云端计费这是一笔可观的支出,而本地是零——这道门槛决定了大多数人的模板永远停留在”随手写写”的水平。
判断二:串行流水线比并行更适配消费级硬件。很多人迷信”多开效率高”,但消费级显卡的显存是硬顶,两个模型争抢的结果是双双降速。串行让每个环节都在显存余量充足的状态下满速运行,总吞吐反而更高,稳定性也完全不同。接受串行,是消费级硬件工作流设计的第一课。
判断三:剧本质量和出图质量要用同一套人设事实约束。分镜脚本、绘图提示词、IP-Adapter 参考图,本质上是同一个人设事实卡的三种投影。任何一处自行其是(LLM 写错发色、绘图提示词漏掉瞳色、参考图用错服装),一致性就会在链条下游崩塌。维护唯一事实源,让每一段生成都引用它,是漫剧跨集一致性的根。
十、进阶路线图:从单机流水线到小型工作室
10.1 第一阶段:单集跑通(第 1-2 周)
目标只有一个:手动走完一集的完整链路,每个环节都亲手操作一遍。这一阶段不要追求自动化,重点是搞清楚每个环节的输入输出和失败模式——Qwen 在什么大纲下会写出越界字段、ComfyUI 在哪个分辨率段会 OOM、图生视频在什么构图下容易崩。把这些坑记进笔记,比急着写自动化脚本有价值得多。
10.2 第二阶段:脚本串联与批量生产(第 3-6 周)
把剧本生成、JSON 校验、队列提交、文件整理写成一条 Python 命令。加入 8.2 节的”首镜质检”逻辑:脚本先渲染 shot01 并暂停,等你确认后按回车继续整批。此阶段的目标是”睡前提交,早上收片”,单机日产能稳定在 2-4 集粗剪。
10.3 第三阶段:加卡扩容与分工
如果产量上来了,最划算的扩容方式是加一张纯绘图卡:LLM 在 A 卡独占跑剧本,绘图在 B 卡独占跑 ComfyUI,两卡之间用共享目录传递 JSON 与图片,串行约束升级为两条互不干扰的并行线。若再进一步,剧本侧可以多人协作——人设卡和分集大纲放在版本库里,编剧改大纲、审核改事实卡,流水线自动感知变更重跑受影响的分镜。到这里,”文字故事→漫剧成片”就不再是一个人的手工活,而是一条可持续运转的小型生产线。
7.3 常见踩坑清单:前人用废片换来的教训
最后汇总一批高频踩坑点,逐条自查可以少走很多弯路:
• 提示词里混入中文人名:绘图模型对人名几乎无感知,只会注入噪声。人名只存在于剧本层,绘图层一律用外貌关键词替代;
• 种子完全随机:每个分镜用不同随机种子会让整集画风各自为政,务必固定基础种子再按 shot_id 做微偏移;
• IP-Adapter 权重拉满:权重超过 0.9 会导致所有分镜构图被参考图带偏,0.6-0.8 是甜点区;
• 一次性生成整季剧本:上下文越长,量化小模型的格式漂移越严重。按”集”为单位生成,每集独立校验,是最稳的粒度;
• 边跑队列边改人设卡:队列进行中修改事实源会导致同集前后分镜设定打架,改动请留到批次结束;
• 忽视负面提示词的全局统一:负面词散落在各分镜里不如从人设卡统一注入,这是最容易被遗忘但收益立竿见影的一致性手段。
常见问题 FAQ
Q1:几 GB 显存能跑这套流程?
8GB 显存是可用下限:7B 4bit 量化的 Qwen(约 5GB)加 SDXL 低显存模式,串行执行可以稳定跑通。12-16GB 会舒服很多,可以上 14B 模型并开启 medvram 之后的更宽松模式。低于 8GB 的卡建议 Qwen 走 CPU offload 或考虑纯云端方案。
Q2:一集漫剧从文字到成片大概要多久?
以 10 个分镜、16GB 显存机器为例:剧本生成 3-5 分钟,ComfyUI 出图每张 20-60 秒共约 5-10 分钟,图生视频每镜 1-3 分钟共约 10-30 分钟,ffmpeg 拼接 1 分钟内。全自动跑完一集粗剪约 20-45 分钟;8GB 卡大约翻倍。人工参与的环节(提示词微调、配音对轴)另计。
Q3:本地 Qwen 的效果比云端差多少?
分镜 JSON 这类结构化任务,14B 量化版与云端旗舰的差距很小,主要差在剧情编排的巧思和长篇连贯性上。对白质感上旗舰明显更好。务实做法是:结构化输出交给本地,重要剧集的剧情大纲用云端打磨一版再喂回本地做分镜。
Q4:整条链路具体怎么串起来?
Ollama 暴露 OpenAI 兼容接口(127.0.0.1:11434),Python 脚本读故事大纲和人设卡,POST 生成请求拿到分镜 JSON;脚本解析 JSON 后读取 ComfyUI 工作流 API 文件,逐条替换提示词与种子,POST 到 127.0.0.1:8188/prompt 排队;轮询 /history 取回成图;图生视频同样走队列;最后 ffmpeg 按序拼接。全程一个 Python 脚本 + 两个本地服务即可。
Q5:怎么保证跨集的角色一致性?
三层保险:人设事实卡作为唯一事实源注入所有生成环节;绘图提示词强制携带角色发色瞳色服装关键词;IP-Adapter 用固定定妆图锁脸。另外整季固定同一个底模、LoRA、采样器和基础种子,任何一项变更都会引起画风漂移。
Q6:生成速度太慢或有 OOM 报错怎么办?
先看 nvidia-smi 确认是否有显存被其他程序占用;OOM 时把 ComfyUI 切低显存启动参数、降低出图分辨率、缩短 LLM 上下文;速度慢优先确认模型真的驻留在显存里(而非 CPU 回退),其次减少出图步数(25 步以下画质损失可控);如果 32B 模型 offload 导致每秒不到 3 个 token,果断换 14B——快得多轮迭代,胜过慢的一次到位。






暂无评论内容