

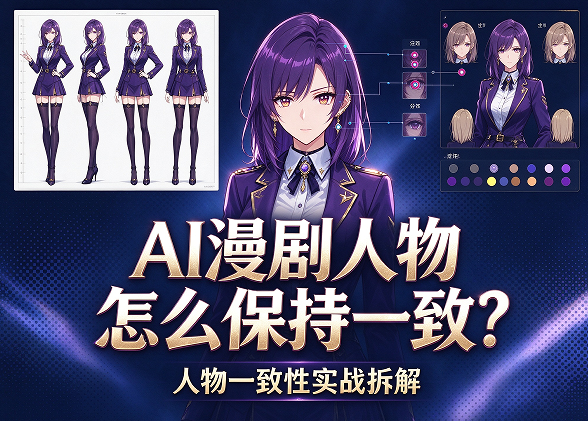
AI漫剧人物的一致性,本质不是“抽卡运气”,而是一套资产管理流程。人物一致性做不好,通常不是模型不行,而是角色没有被当作可复用的资产来对待。本文从三视图、视觉锚点、参考图策略到多工具编排,拆解一套真正可执行的人物一致性方案。
一、AI漫剧人物的“变脸”,根源不在模型
AI漫剧最让人头疼的瞬间,不是分镜画错了,也不是配音对不上口型,而是一张新图生成出来,主角的脸“换了一个人”。
很多人的第一反应是模型不行、工具不够强。但2026年的模型能力已经足够好了——Midjourney、Nano Banana Pro、GPT-Image 2、即梦、可灵,随便哪一个,单独生成一张高质量的漫剧人物图都不是难事。真正的问题出在生成逻辑本身:每一次文生图都是一次独立的采样过程。模型不知道“上一张图里的那个人”长什么样,它只知道你这一次写下的提示词。
“千人一面”的讨论在2026年已经非常普遍。吉林大学新闻与传播学院副院长姜明在接受采访时指出,AI短剧和AI漫剧中大量雷同的角色面孔,背后有技术稳定的考量,但更根本的问题在制作前期:人物设计的精细程度,直接决定了千人一面问题的严重程度。另一个被反复提及的现实因素是成本——如果给AI的信息量太少,模型就会从训练数据中寻找最熟悉的角色类型来填充,因为这是“最安全”的输出路径。
所以,AI漫剧人物一致性的第一个认知转变是:不要把角色当成“每次生成的产物”,要把角色当成“第一次就必须建好的资产”。 后续所有的生成,都是在复用这个资产,而不是重新制造它。
二、人物一致性的基础:先把角色变成“资产”
2.1 为什么三视图是漫剧人物的第一张牌
在传统动画和漫画制作中,角色三视图(正面、侧面、背面)是行业标准配置。AI漫剧把这个逻辑继承了下来,原因很实际:三视图是给模型“看”的人物身份证。
文生图模型不理解“同一个人”这个概念,但它理解视觉特征的相似性。如果你有一张清晰的正面图、一张侧面图和一张背面图,后续生成时把这三张图作为参考输入,模型就有了一个稳定的视觉锚点。漫画学院的AI漫剧专项培训中明确提出,前期必须完成“角色、场景、道具等视觉资产搭建”,人物形象、场景风格及画面语言的一致性都要建立在资产之上。
三视图的价值不仅在于“给参考图”。它强迫创作者在项目开始之前,把角色的脸型、发型、五官比例、体型特征、服装细节全部确定下来。一致性问题的很大一部分,其实是在设计阶段就埋下的。 如果角色本身没有清晰到可以被描述、被复现的程度,任何工具都无法替你“保持一致”。
2.2 角色档案:把视觉特征翻译成模型能读懂的文本
三视图解决的是“图”的层面,角色档案解决的是“文”的层面。
一个可复用的角色档案,至少应该包含以下维度:
| 档案维度 | 需要锁定的信息 | 示例描述方向 |
|---|---|---|
| 脸型与五官 | 轮廓、眼型、鼻型、唇形、眉形 | 鹅蛋脸,眼尾微垂,鼻梁窄直 |
| 发型 | 长度、分缝、发色、质感 | 黑色长直发,中分,发尾微卷 |
| 体型 | 身高感、肩宽、体态倾向 | 瘦削,窄肩,站姿略微前倾 |
| 标志特征 | 疤痕、痣、配饰、瞳色 | 左眉尾有一道浅疤,瞳孔偏琥珀色 |
| 服装基底 | 主色调、材质、固定单品 | 深灰色高领内搭,外罩短款夹克 |
这张表的意义在于:它把“那个看起来很酷的男主”这种模糊判断,转化为一组每次生成都可以复用的约束条件。提示词是消耗品,每次都要重写;角色档案是资产,写一次,用一百次。
2.3 视觉锚点:比“描述”更稳定的东西
漫画学院的培训材料中提到了一个值得展开的概念:视觉锚点。培训指出,在AI视频生成过程中,应“充分利用角色、场景等视觉锚点保持画面连续性”。
视觉锚点的逻辑是:在一部漫剧中,每一帧画面都包含大量信息,但模型对信息的注意力是分散的。如果你试图让模型同时“记住”角色的全部特征,它反而可能什么都记不牢。更有效的方式是选定两到三个不可妥协的特征,作为每一张图都必须出现的锚点。
比如:一个角色的琥珀色瞳孔、左眉尾的疤痕、以及永远戴在右手腕上的编织手绳。这三样东西,在任何角度、任何场景、任何表情下都不能消失。模型可能把发型画得略有偏差,可能把外套的颜色调深了一度,但只要锚点还在,观众就会认为“这是同一个人”。
一致性的感知,并不要求像素级的相同,而要求特征层面的可识别性。 理解这一点,能从“追求完全不变”的执念中解放出来,把精力集中在真正影响辨识度的少数特征上。
三、主流工具在人物一致性上的真实能力对比
2026年的AI漫剧工具格局已经比较清晰,但在“人物一致性”这个具体维度上,各家的实现路径和能力边界差异很大。以下对比聚焦于漫剧场景下的角色一致性表现,而不是通用图像质量。
| 工具 | 一致性核心机制 | 漫剧场景优势 | 漫剧场景局限 | 适合的团队形态 |
|---|---|---|---|---|
| Midjourney V8.1 | --cref角色参考 + --oref对象参考 | 角色氛围感和风格统一性极强,适合确立漫剧的整体视觉调性 | 文字渲染弱,精确控制依赖参数经验,一致性在复杂场景切换时容易漂移 | 有审美判断力的中小团队 |
| Nano Banana Pro | 多图输入 + 跨场景一致性控制 | 三视图生成、多图融合、切换视角的能力突出,适合作为“资产中枢” | 生成速度较慢,数据策略需自行评估 | 需要批量资产管理的漫剧项目 |
| 即梦AI | 角色参考 + 连续生图一致性流 | 中文生态友好,漫剧适用比例和连续生图流程成熟 | 一致性上限受模型版本影响,跨风格迁移能力有限 | 国内漫剧团队,追求流程顺畅 |
| GPT-Image 2 | 对话式编辑 + 参考图继承 | 可以在对话中逐步修正角色细节,零门槛维持单次会话内的一致性 | 跨会话的一致性继承不如图像专用工具稳定 | 需要快速迭代角色方案的创作者 |
| Stable Diffusion + LoRA | 角色专属LoRA模型 | 一致性上限最高,角色特征可以被“固化”进模型权重 | 训练成本高,需要数据集准备和参数调试,不适合零基础 | 有技术能力、追求长期资产复用的团队 |
| 可灵 | 人物图参考 + 三视图支持 | 与视频生成环节衔接紧密,角色图可以直接驱动后续动效 | 生图阶段的一致性控制精细度中等 | 以视频产出为终点的漫剧流水线 |
这张表里最值得注意的,不是某个工具“更强”,而是一致性的实现层次完全不同。Midjourney和即梦属于“参考图约束层”——每次生成时把角色图喂进去,让模型尽量靠近;Nano Banana Pro和GPT-Image 2属于“对话与融合层”——通过多轮交互和图像融合来维持连贯;Stable Diffusion + LoRA属于“模型固化层”——把角色特征直接训练进一个专属模型,生成时不需要反复提供参考。
没有一种方式在所有场景下都是最优的。LoRA的一致性上限最高,但它的“固化”也意味着灵活性最低——角色换一套服装、换一个年龄段,LoRA需要重新训练或叠加新的控制层。参考图路线的一致性上限稍低,但迭代速度快,适合漫剧这种角色状态经常变化的场景。
四、一条可落地的人物一致性工作流
4.1 第一阶段:角色资产库的搭建(不要跳过)
任何试图“边生成边统一”的做法,最终都会付出更高的返工成本。漫剧的人物一致性,必须从资产库开始。
资产库的最小构成是:每个主要角色一套三视图 + 一份角色档案 + 两到三张“锚点特写”。三视图交给模型作为空间参考,角色档案交给创作者作为文本约束,锚点特写用来在生成结果中快速校验一致性是否达标。
即梦和Nano Banana Pro都明确支持三视图生成和跨场景一致性控制,这意味着资产库的建立本身已经可以由AI辅助完成,不需要从零手绘。但AI生成的三视图需要经过人工筛选和修正——如果三视图本身就有偏差,后续所有的一致性控制都会建立在错误的基准上。
4.2 第二阶段:参考图策略——给什么图,比给多少图更重要
参考图不是越多越好。模型对参考图的注意力是有限的,过多、过于杂乱的参考图反而会稀释核心特征。
一个实用的策略是分层提供参考:
- 主参考图:一张最清晰、最正面的角色图,作为面部特征的第一基准。
- 角度补充图:侧面或四分之三侧面一张,帮助模型理解三维结构,避免正面图被过度平铺到所有角度。
- 锚点特写图:一到两张局部特写,强调必须保留的细节(瞳色、疤痕、配饰)。
- 风格参考图(可选):如果漫剧有强烈的画风要求(如厚涂、赛璐璐、水墨),单独提供一张风格图,与角色图分开输入。
在Midjourney中使用--cref时,可以把角色图放在参考位置,同时通过--cw参数控制参考强度。在Nano Banana Pro中,多图输入的顺序和描述文本中的角色指代需要对齐,否则模型可能把不同角色的特征混淆。
4.3 第三阶段:生成中的一致性校验——不要等到最后才发现“变脸”
一个被低估的环节是在生成过程中就做一致性判断,而不是等整集做完再回头看。
具体做法是:每生成一组新图,先对照角色档案中的锚点特征做一次快速核查。如果锚点丢失,不要试图“下一张可能会好”,而是回到参考图配置或提示词层面找原因。常见的锚点丢失原因包括:场景描述过于复杂导致角色特征被稀释、光照条件变化过大(比如从日景切到夜景)导致肤色和瞳色判断偏移、以及多角色同框时模型对个体特征的注意力分配不足。
漫画学院培训中提到的180度轴线原则在漫剧一致性中同样适用:不仅人物关系不能越轴,角色的视觉特征也不应该在轴线切换时发生不合理的翻转。一个左眉有疤的角色,在镜头反打之后如果疤痕跑到了右眉,一致性就已经破了。
4.4 第四阶段:从“单张一致”到“跨场景一致”
漫剧的真正难点不在于同一场景下的多张图保持一致,而在于角色从一个场景走到另一个场景时,仍然是同一个人。
Nano Banana Pro在这一层提供了比较完整的工具链:三视图生成、多图融合、跨场景一致性、切换视角,构成了一个连贯的控制序列。这个序列的逻辑值得借鉴,即使你使用的不是Nano Banana Pro:
先固定视角,再迁移场景。 不要试图一步生成“角色在雨夜街头”的完整画面。先用三视图锁定角色在标准光照下的形象,再生成角色在目标场景中的姿态和构图,最后用融合或图生图的方式把角色“放入”场景。每一步只改变一个变量,一致性才有被追踪和修正的可能。
五、进阶:把一致性从“控制”变成“工程”
5.1 LoRA路线:一致性上限最高,但门槛不在训练
LoRA训练一个角色模型,在2026年已经比前两年简单很多。开源社区有成熟的训练指南,数据集准备、打标、参数设置都有可循的流程。但LoRA在漫剧场景中的真正难点,不在训练本身,而在版本管理。
一部漫剧的主角可能有多个状态:常态、战损、换装、幼年回忆、情绪极端化。每一个状态如果都用独立的LoRA,就会出现“模型碎片化”——你不再拥有一个“角色”,而是拥有五个互不兼容的角色变体。更务实的做法是:一个基础角色LoRA + 通过提示词和控制层来衍生状态,只在角色发生不可逆的视觉改变时(比如获得了永久性伤疤或改变了发色)才更新基础模型。
5.2 多工具编排:不要指望一个工具解决所有一致性问题
a16z在2026年关于图像生成的一份分析中提出了一个判断:这个领域不存在“统治一切”的模型,真正的能力在于把多个模型编排成工作流。漫剧人物一致性恰恰是这种编排思维的典型应用场景。
一个经过验证的分层编排思路是:
| 环节 | 适合的工具类型 | 承担的一致性职责 |
|---|---|---|
| 角色概念确立 | 对话式生图工具(GPT-Image 2等) | 快速迭代角色方向,确定锚点特征 |
| 三视图与资产化 | 多图融合工具(Nano Banana Pro等) | 建立可复用的角色视觉基准 |
| 批量分镜生成 | 参考图约束工具(Midjourney、即梦等) | 在大量画面中维持角色可识别性 |
| 精确局部控制 | Stable Diffusion + ControlNet/LoRA | 修正姿态、锁定细节、处理复杂交互 |
| 最终校验与修复 | 图生图 + 局部重绘 | 修复一致性漂移,统一画风 |
这个编排的关键在于:资产化阶段用“融合型”工具,批量生成阶段用“约束型”工具,修正阶段用“控制型”工具。 让每个工具做它最擅长的事,而不是试图让一个工具从头扛到尾。
5.3 一个被忽视的一致性维度:画风一致性
人物一致性不只是“脸不变”。漫剧观众对“同一个人”的判断,很大程度上依赖于线条语言、上色逻辑和光影处理方式是否连贯。
一个角色在三视图里是清晰的赛璐璐风格,到了正片里变成了厚涂质感,即使五官完全一致,观众仍然会觉得“这不是同一个人”。所以,人物一致性工作流中必须包含画风锁定环节。可以在提示词中固定风格关键词,可以使用风格参考图(Midjourney的--sref或Nano Banana Pro的风格参考输入),也可以把画风要求写入角色档案,作为每一次生成的硬性约束。
六、关于AI漫剧人物一致性的几个独立判断
第一,“一致性”正在从技术问题变成制片管理问题。 2024年的时候,人物一致性主要是一个“能不能做到”的技术问题。到2026年,主流工具在单张或短序列层面已经基本够用,真正的差距出现在项目规模上。一部20集以上的漫剧,角色会在上百个场景中出现,一致性会随着序列长度增加而逐渐漂移。这时候需要的不是更好的模型,而是版本控制、资产复用和定期校验的流程。把角色当资产来管理,比追求某个工具的“最强一致性参数”更有长期价值。
第二,LoRA不是终点,“混合一致性策略”才是。 有一种流行的观点认为,训练了角色LoRA就一劳永逸地解决了一致性问题。实际并非如此。LoRA把角色“固化”了,但漫剧需要角色在固化中保持可变化——换表情、换服装、换年龄段、换情绪状态。更合理的策略是LoRA负责底线一致,参考图和提示词负责状态变化,ControlNet负责姿态和构图。三层各司其职,而不是把全部一致性压力压在一个模型权重上。
第三,观众对一致性的容忍度比创作者想象的高,但锚点的丢失是不可原谅的。 在测试中反复出现的一个现象是:观众可以接受角色的发型在某个角度下略有不同,可以接受外套颜色在不同光照下看起来有偏差,但一旦锚点特征(比如标志性的瞳色或疤痕)消失,观众会立刻感觉到“这不是那个人”。这意味着一致性工作的优先级应该是先守住锚点,再追求细节,而不是反过来。
第四,AI漫剧人物的最高一致性,最终来自“设计的一致性”,而不是“生成的一致性”。 如果一个角色在设计阶段就拥有足够鲜明、足够可描述的视觉特征,后续生成的一致性难度会大幅下降。反过来,一个“好看但模糊”的角色设计,无论用什么工具、跑多少次生成,都会持续产生“长得像但说不清哪里不对”的结果。把时间花在前期的角色设计上,是一致性投入中回报最高的一笔。
FAQ
Q1:AI漫剧人物一致性,优先用LoRA还是参考图?
取决于项目规模和角色数量。单部短篇漫剧、角色数量少、状态变化频繁,参考图路线更灵活,迭代更快。长篇连载、核心角色需要跨集甚至跨季保持稳定,LoRA的固化能力更有价值。很多成熟团队的做法是混合使用:主角用LoRA守住底线,配角用参考图控制。
Q2:三视图必须用AI生成吗?手绘的可不可以?
完全可以,而且手绘的三视图在精确度上通常优于AI生成。AI生成三视图的优势是速度快、风格容易统一,但它可能在三视图内部就产生轻微的不一致。如果团队有绘画能力,手绘或手修三视图作为资产基准,后续交给AI做批量生成,是更稳妥的路径。
Q3:为什么角色在同一场景的不同角度下,一致性容易崩?
这是文生图模型的固有限制:模型对正面特征的学习通常最充分,对侧面和背面的“理解”依赖于训练数据中的统计规律,而不是真正的三维推理。解决方案是在参考图中提供多角度视图,而不是只给一张正面图,让模型有足够的空间信息来约束不同角度的生成。
Q4:多角色同框时,模型经常把特征“串”到一起,怎么处理?
这是多角色场景中最常见的问题,根源是模型对提示词中角色描述的顺序和指代关系理解不稳定。可以尝试:把每个角色的描述在提示词中分组、分段,避免特征词交错;使用区域控制工具(如ControlNet的OpenPose配合区域提示)把每个角色约束在画面中的特定位置;或者在后期用局部重绘分别修正每个角色的细节。
Q5:AI生成的角色图有轻微偏差,但整体“感觉是对的”,要不要重抽?
不要追求单张的完美。如果锚点特征全部保留,偏差发生在非锚点维度(比如发丝走向、衣褶细节),优先进入下一张生成,在序列层面判断一致性趋势。单张重抽的成本很高,而且可能引入新的偏差。真正需要重抽的信号是锚点丢失,而不是任何细节的不一致。
Q6:AI漫剧人物的一致性,有没有“够用”的标准?
有一个实用的判断标准:把同一角色的三张不同场景图并排放在一起,让一个没有参与制作的人判断“这是不是同一个人”。如果答案是肯定的,一致性就达到了漫剧观众可接受的水平。如果对方需要犹豫或者需要“仔细看”,说明锚点还不够鲜明,或者画风一致性出了问题。






暂无评论内容